AI画像認識を自作する方法 必要な知識・開発の手順・学習データの準備・業務活用の進め方
 2026年9月14日
 著者:NEXT SCALE編集部
監修者:石丸真平
「製品の外観検査を自動化したい」「手書き帳票の文字を読み取りたい」「カメラ映像から特定の物体を検出したい」。こうした課題を解決する手段として、自社データを使ってAI画像認識モデルを構築する「自作」が注目されています。市販サービスもありますが、独自の製品外観や帳票、検査基準など、汎用サービスでは対応しにくい業務では専用モデルが必要になる場合があります。
現在は画像認識の開発に使えるツールやライブラリも充実しており、基礎的なプログラミング知識があれば自作に挑戦できる環境が整っています。本記事では、AI画像認識を自作するために必要な知識から、開発手順、学習データの準備、モデルの学習・評価、実際の業務へ組み込む方法まで、実務の観点からわかりやすく解説します。
| 確認したいポイント | 結論 |
| 自作に必要なスキルは? | プログラミング言語の基礎知識が最低限必要。初学者でもライブラリの活用で開発は可能 |
| 費用はかかるか? | 開発ツールとライブラリは無料。高性能な計算環境が必要な場合はクラウドの利用料が発生 |
| どのくらいの期間で作れるか? | 簡易な分類モデルなら数日〜数週間。業務レベルの精度を目指す場合は数か月を要することも |
| 市販サービスと自作の違いは? | 自作は自社データへの最適化と柔軟なカスタマイズが可能。市販は手軽だが汎用的な精度にとどまる |
この記事でわかること
・AI画像認識を自作するために最低限必要な知識とツール
・開発の全体手順を5つのステップで整理した流れ
・学習データの収集・加工・増強の具体的な方法
・自作と市販サービスの使い分けの判断基準
・業務に実装して成果を出すための現実的な進め方
| \ AI開発・業務効率化のご相談はネクストスケールへ / ▶ 無料で経営相談する |
 こんな方におすすめ

AI画像認識を自作するために必要な知識とツール
プログラミング言語の基礎
AI画像認識の開発では、機械学習や画像処理に必要なライブラリが最も充実しているプログラミング言語が広く使われています。変数、関数、条件分岐、繰り返し処理といったプログラミングの基本概念を理解していれば、画像認識AIの開発に着手するための最低限の準備としては十分に整っている状態ですので、まずは一歩を踏み出してみることをおすすめします。
機械学習の基本概念
画像認識は「教師あり学習」と呼ばれる機械学習の手法を用いて画像の特徴を学習させるのが最も基本的で広く採用されているアプローチです。「この画像は○○である」というラベル(正解データ)を大量に与えて、AIに画像の特徴とラベルの対応関係を学習させる仕組みです。「犬」というラベルが付いた画像を数百枚から数千枚にわたって読み込ませて学習させることで、AIは新しい画像を見たときに「これは犬の画像である」と高い確率で自動的に判定する能力を獲得していくのです。
画像処理と機械学習のライブラリ
画像認識の開発では、画像の読み込み・加工を行うためのライブラリと、機械学習モデルの構築・学習を行うためのライブラリを組み合わせて使用するのが一般的です。これらはすべて無料で公開されており、インストールするだけで本格的な画像認識モデルの構築に必要な一通りの開発環境を手元に揃えることが可能です。ゼロからアルゴリズムを実装する必要はなく、世界中の開発者が公開しているライブラリの豊富な機能を目的に応じて組み合わせ、効率的にモデルを構築していくのが2026年現在においてAI画像認識の開発現場で最も広く採用されている標準的な手法です。
計算環境の準備
機械学習の「学習」の工程では大量の計算を行うため、大量の画像データを効率的に処理するための高性能な演算装置の利用が不可欠になる場合があります。自前のパソコンで処理できる規模のモデルもありますが、大量の画像を使った本格的な学習にはクラウドの計算サービスを利用するのが一般的です。無料で使える範囲のサービスもあるため、初めて取り組む方は、まずは無料で使える範囲のサービスで学習の体験を積んでから、必要に応じて有料の計算資源に移行するのがおすすめです。
AI画像認識を自作する全体手順 ─ 5つのステップ
ステップ1:解決したい課題と認識対象を明確にする
開発の第一歩は、いきなりプログラミングのコードを書き始めることではなく、「何を認識させたいのか」「なぜそれを認識する必要があるのか」を明確に定義することです。「良品と不良品を分類したい」「手書きの数字を読み取りたい」「特定の物体の有無を検出したい」など、目的によって必要なモデルの種類、必要なデータの量と準備の方法、学習の進め方が大きく異なってくるため、この最初の定義が後のすべての工程の質と方向性を決定づけます。
ステップ2:学習用の画像データを収集・整理する
AIに認識させたい対象を含む画像を実際の業務環境から大量に収集していきます。最低でも各カテゴリにつき数百枚以上の画像を用意し、画像ごとに正解のラベルを付ける「アノテーション」の作業を行います。この学習データの量と質が、完成するモデルの認識精度を直接的かつ決定的に左右する、開発プロセス全体の中で最も重要かつ手間のかかる工程です。
自社の業務で発生する実際の画像を使うことが、自社の業務環境に特化した高精度のモデルを生み出すための最も決定的な鍵になります。インターネット上の一般的な画像だけで学習させると、実際の業務現場で使用した際に期待していた精度を大きく下回り、実務では使いものにならないという残念な結果を招いてしまうことがあります。
ステップ3:モデルを構築して学習を実行する
収集した画像データを画像認識のためのモデルに読み込ませて学習を実行します。ゼロからモデルを構築する方法もありますが、2026年現在では「転移学習」と呼ばれる手法が主流です。転移学習とは、大量の画像データで事前に学習済みのモデルをベースに、自社が集めた比較的少量の画像データだけを使って追加の微調整学習を行う方法であり、少量の自社データで効率よく高い認識精度を実現できるという、実務面で非常に大きな利点があります。
ステップ4:精度を評価し、改善を繰り返す
学習が完了したモデルに、学習に使っていない画像(テストデータ)を入力し、「正しく認識できた割合(正答率)」を測定してモデルの精度を評価します。精度が業務上の要求水準に満たない場合は、学習データの追加・加工、学習条件の調整、データの前処理の改善といった手法で精度の向上を図り、目標の精度が達成されるまで何度もデータと設定を見直す粘り強い取り組みが求められます。
ステップ5:業務システムに組み込んで運用する
精度が確認できたモデルを、実際の業務で使用するアプリケーションやシステムに組み込み、リアルタイムで画像を認識できる状態にして運用を開始します。カメラの映像を入力として受け取り、認識結果を画面に表示したり、後続の業務システムにデータを送信したりするなど、日常の業務オペレーションの流れの中に自然に組み込まれ、担当者に余計な負担をかけることなく活用される仕組みとして設計し、構築していきます。
関連記事:業務効率化アイデア55選|部門別30+AI15+明日から3つで成果を出す方法
| \ AI開発・業務効率化のご相談はネクストスケールへ / ▶ 無料で経営相談する |
 サービス資料をダウンロードする
学習データの準備 ─ 精度を左右する最重要ポイント
自社の現場で発生する「実際の画像」を使う
画像認識の精度は、学習データがどれだけ実際の使用環境に近いかで決まります。照明条件、撮影角度、背景の色、画像の解像度など、実際の業務で発生する画像の条件をできるだけ忠実に再現した画像を学習データとして使用することが、現場に導入したときに「使える」と評価される精度を実現するための最も重要なポイントです。
データ拡張で画像の枚数を増やす
学習に必要な画像の枚数が不足している場合、既存の画像を回転、反転、拡大縮小、色調変換、ノイズ追加などの加工によって水増しする「データ拡張」の手法が有効です。データ拡張を行うことで、少ない元画像から多様なバリエーションを生成でき、少ないデータでも認識精度を底上げし、特定のパターンにだけ過剰に適合してしまう「過学習」を防止する効果を同時に得ることができます。
アノテーションの品質を管理する
学習データに付けるラベル(アノテーション)の正確さは、モデルの精度に直結します。ラベルの付け間違いや基準のばらつきがあると、AIは誤ったパターンを学習してしまいます。アノテーションのルールを事前に明文化し、複数の担当者が作業する場合は判断に迷うケースについての基準をあらかじめ明確にし、作業者間でばらつきが出ないようにアノテーション作業そのものの品質を組織的に管理し、ラベルの正確性と一貫性を担保するための体制をプロジェクトの初期段階から整えておくことが不可欠です。
自作と市販サービスの使い分け
AI画像認識を業務に導入する方法は、自作だけではありません。市販のクラウド型画像認識サービスや、学習済みのモデルを提供するサービスも数多く存在します。自作と市販サービスには、それぞれ異なる強みと限界があるため、自社の業務要件や技術力、予算に応じて適切に使い分けるという冷静な判断が求められます。
自作が適している場面
自社の製品や帳票など、一般に流通していない独自の画像を認識させたい場合は、自社のデータで学習させた独自のモデルが必要です。また、既存のサービスでは対応できない特殊な検出条件(「傷の大きさが何ミリ以上なら不良品」など)が求められる場合や、認識結果を自社の業務システムに深く組み込みたい場合も、独自のモデルを自社のデータで構築する自作のアプローチが最も適しているといえます。
市販サービスが適している場面
一般的な文字認識や顔検出、物体の分類など、汎用的な画像認識であれば、市販のサービスを利用するほうが開発期間も費用も大幅に抑えられます。市販サービスは精度も高く、すぐに利用開始できるため、自社の要件が汎用的な範囲に収まる場合は、まず市販サービスの無料体験やトライアルを活用して自社の画像での精度を検証してから、不足があれば自作を検討するのが、時間と費用の両面で最も効率的かつ合理的な進め方です。
関連記事:AI研修とは|目的・種類・費用・助成金から失敗しない選び方まで
まとめ
AI画像認識は、プログラミングや機械学習の基礎知識があれば、無料のライブラリやクラウド環境を活用して自作できます。基本的な流れは「課題と認識対象の定義→学習データの準備→モデルの構築・学習→精度の評価・改善→業務への実装」の5ステップです。
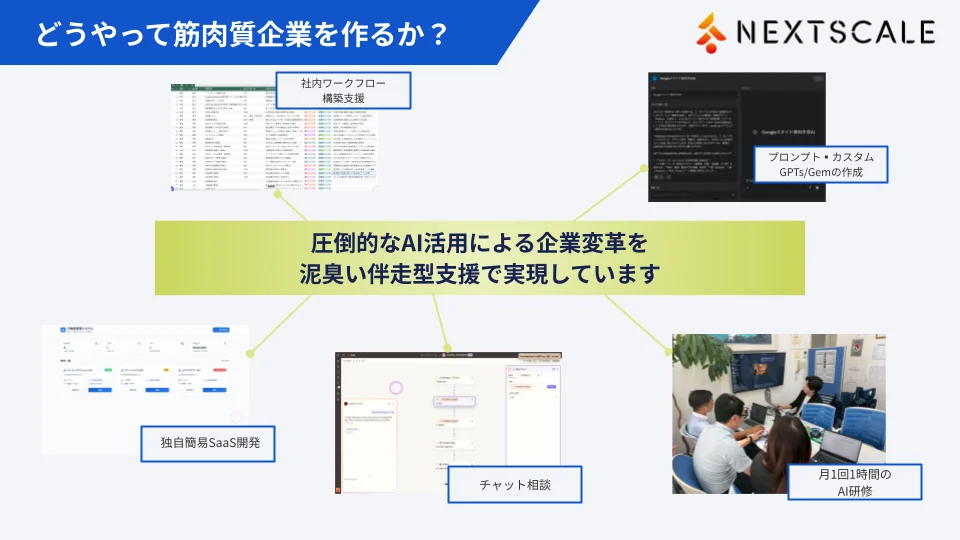
特に重要なのが学習データの質と量です。実際の現場で発生する画像を集め、適切にアノテーションやデータ拡張を行うことで、実用性の高いモデルを目指せます。汎用的な用途では市販サービスも選択肢ですが、自社固有の画像を高精度で認識したい場合は、自社データを使ったモデル開発が有効です。「画像認識AIを自作したい」「自社に合ったAI開発方法を知りたい」という方は、ネクストスケールにご相談ください。課題整理から開発支援、社員研修まで一貫してサポートします。
AIコンサル・AX伴走支援サービスご紹介資料
この資料でこんなことがわかります!
- 社外AI役員とは
- 支援内容
- 導入の進め方
- 導入実績・効果
\3ステップで簡単入力/
この記事の監修者
株式会社ネクストスケール 代表取締役

関連記事
-
 AI受託開発とは?依頼できること・費用相場・開発会社の選び方と成功のポイントを解説
-
AI開発のPoCとは?進め方・費用・成功のポイントと「PoC止まり」を防ぐ方法を解説
-
バイブコーディングとは?やり方・おすすめツールとメリット・注意点を解説【2026年最新】
-
AIアプリおすすめ15選|無料で使える目的別の選び方と業務利用の注意点【2026年最新】
-
AIを活用したアプリ開発とは?手順・費用・おすすめツールまで解説
-
AIアプリ開発の費用相場は?内訳・種類別の目安と費用を抑える方法
-
AIアプリ開発をノーコードで実現!おすすめツールと進め方を解説
-
AIプロダクト開発の進め方とは?手順・開発手法・成功のポイントを解説