AIストレージとは?自社に必要なのはどちらか、性能とデータ整備の切り分け
 2026年9月14日
 著者:NEXT SCALE編集部
監修者:石丸真平
「AIストレージ」を調べると、高速な読み書き、大容量、GPUを止めない帯域といった説明が並びます。桁の大きな数字を見て、自社には縁遠い話だと感じた方もいるかもしれません。
その感覚は、多くの場合正しいものです。こうした説明は、モデルを自社で学習させる企業に向けたものだからです。
既存のAIサービスを使う企業にとって、ストレージの課題は性能ではありません。どこに何があるか分からない、誰が見てよいかが曖昧、古い文書が混ざっている。この状態のままAIを入れると、期待した結果は得られません。
本記事では、2つの意味を切り分けたうえで、自社に必要なのはどちらかの判断、そして大多数の企業に当てはまるデータ整備の進め方を解説します。製品の比較ではなく、何に投資すべきかを決めるための材料として整理しました。
| 確認したいポイント | 結論 | 詳細 |
| AIストレージとは? | 2つの意味がある | AI学習向けの高性能基盤と、AIに読ませるデータの置き場。 |
| 自社にはどちらが必要? | 多くの企業は後者 | モデルを自社で学習しないなら、高性能基盤は不要になる。 |
| 何が課題になる? | 性能より検索性と権限 | 整理されていない状態でAIを入れると、誤った回答が返る。 |
| 最優先の対応は? | 権限設計の見直し | 見えてはいけない文書がAIの回答に出る事故が起こり得る。 |
この記事でわかること
- 「AIストレージ」が指す2つの意味と、自社に必要なのはどちらか
- モデルを自社で学習する場合に求められる性能と、その条件
- AIサービスを使う企業に必要なデータ整備の観点
- 既存のストレージのままAIを導入したときに起きる問題
- データ整備の進め方と、保存すべきデータの判断
| AI活用に向けたデータ整備について、支援内容とあわせて資料にまとめています。 >> 資料請求はこちら |
 こんな方におすすめ

「AIストレージ」には2つの意味がある
検索して出てくる情報が自社の状況と噛み合わないと感じるのは、同じ言葉が2つの異なる対象を指しているためです。
まずここを切り分けます。
意味1|AI学習向けの高性能なストレージ基盤
1つ目は、機械学習の処理そのものを支えるインフラです。大量のデータを高速に読み書きし、GPUを待たせないことが求められます。
学習の過程では、同じデータセットを繰り返し読み込みます。読み込みが遅いと、高価なGPUが待機状態になり、計算資源が無駄になります。このため、高速な記憶媒体と広い帯域が必要になります。
ベンダーが「AIストレージ」として紹介しているのは、主にこちらです。
意味2|AIに読ませるデータの置き場
2つ目は、AIが参照する社内文書やデータの保管場所です。社内の資料をもとに回答する仕組みを作る場合、AIはここを読みに行きます。
ここで求められるのは、読み書きの速さではありません。必要な文書が見つかること、誰が見てよいかが正しく設定されていること、内容が最新であることです。
性能の問題ではなく、整理の問題として現れます。
自社に必要なのはどちらか
判断は単純です。次の表で確認してください。
| 自社の状況 | 必要になるもの | 検討の中心 |
|---|---|---|
| モデルを一から学習させる | 高性能なストレージ基盤 | 帯域、遅延、階層化、コスト |
| 既存モデルを追加学習させる | 中程度の性能と大容量 | データ量と保管コスト |
| 既存のAIサービスを使う | データの整備 | 検索性、権限、鮮度 |
| 社内文書をもとに回答させる | データの整備 | 同上に加えて重複と版の管理 |
多くの企業は下の2行に該当します。モデルを自社で学習させる企業は、業種と規模が限られます。自社が該当しないのであれば、高性能な基盤の検討は不要です。
この切り分けを最初にやっておくと、情報収集の方向が定まります。ベンダーの解説記事は前者を前提に書かれているため、後者に該当する企業が読んでも判断材料になりません。「自社には縁遠い話に見える」という感覚は、対象が違うことのサインです。
モデルを学習させる場合に必要になること
該当する企業は限られますが、判断の材料として概要を整理しておきます。自社が該当しないことを確認する目的でも読んでください。
ここでは3つの観点で見ていきます。
求められる性能
学習の工程では、大量のデータを繰り返し読み込みます。読み込みが追いつかないと、計算する側が待つことになります。
このため、高速な記憶媒体、複数のノードに分散して並列に読める構成、広い帯域が求められます。推論の段階でも、応答の速さを保つために低い遅延が必要になります。
扱うデータも、文書だけでなく画像、音声、センサーの記録など多様になります。形式の異なるデータをまとめて扱える構成が前提になります。
階層化とコストの管理
すべてのデータを高速な媒体に置くと、費用が膨らみます。頻繁に使うデータは高速な領域に、使用頻度の低いデータは安価な領域に置く階層化が一般的です。
重複したデータを取り除く処理や圧縮も、容量と費用を抑えるうえで効いてきます。AI向けの製品には、こうした機能が備わっているものが多くなっています。
該当する企業は限られる
この規模の投資が必要になるのは、独自のモデルを開発する企業、大量の画像や動画を扱う研究開発部門、規制上の理由で外部サービスを使えない組織などです。
「AIを使う」ことと「AIを作る」ことは別です。既存のサービスを使う場合、学習に必要な計算とデータの読み書きは提供元が担っています。自社で用意する必要はありません。
| 自社に必要なのはどちらか、現状を伺ったうえで整理をお手伝いします。 >> 相談予約はこちら |
 サービス資料をダウンロードする
AIサービスを使う企業に必要な整備
ここからが、多くの企業に当てはまる内容です。社内文書をAIに読ませて回答させる仕組みでは、ストレージに求められるものが変わります。
ここでは4つの観点を整理します。
速さより「見つかること」
社内文書をもとに回答する仕組みでは、AIがまず関連する文書を探します。ここで適切な文書が見つからなければ、いくら高性能なモデルを使っても正しい答えは返りません。
ファイル名が「資料.pdf」「最新版_v3.xlsx」といった状態では、探しようがありません。中身を読めば分かるとしても、探す段階では手がかりになりません。
IPA(情報処理推進機構)も、AIの活用にあたっては、正確で最新の、抜け漏れのないデータを整えることが重要であるという趣旨を示しています。整備の質が結果を左右します。
最大の論点は権限の設計
ここが最も重大な項目です。AIが参照できる範囲と、利用者が本来見てよい範囲が一致していないと、事故が起こります。
人事評価の資料、給与の情報、未発表の経営判断。こうした文書がフォルダに紛れていて、AIがそれを読んで回答すれば、本来アクセスできない人に内容が伝わることになります。
従来は「知らなければ探せない」という状態が、事実上の防御になっていました。AIが横断的に検索するようになると、この前提が崩れます。
個人情報を含む文書の扱いについては、個人情報保護委員会が法令や指針を公開していますので、自社の運用が適切かを確認してください。
古い文書と重複した文書
同じ内容の文書が複数の版で存在し、どれが最新か分からない状態はよくあります。AIはこの区別ができず、古い版を根拠に回答する可能性があります。
廃止された規程、変更前の価格表、旧組織の体制図。これらが残っていると、誤った情報が最新のものとして返ってきます。
AIに読ませる範囲を決める際は、まず古い文書を除外する作業が必要になります。
メタデータの整備
文書に、作成日、更新日、部門、種類、有効期限といった情報を付けておくと、検索の精度が上がります。「最新の」「営業部の」といった条件で絞り込めるようになります。
すべての文書に手作業で付けるのは現実的ではありません。フォルダ構成である程度代替する、今後作る文書から付けるといった進め方になります。
整備の観点を整理する
4つの観点を、確認できる形にまとめると次のようになります。自社の状況がどこにあるかを確認してください。
| 観点 | 確認すること | 整っていない場合の症状 |
|---|---|---|
| 検索性 | ファイル名と保管場所から内容が分かるか | 関連文書が見つからず回答できない |
| 権限 | AIの参照範囲と閲覧権限が一致しているか | 見えてはいけない内容が回答に出る |
| 鮮度 | 古い版や廃止済みの文書が混在していないか | 誤った情報が最新として返る |
| 形式 | 文字として読み取れる形式になっているか | 重要な文書ほど読み取れない |
この4点のうち、権限だけは事故につながります。他の3つは精度の問題ですが、権限は情報の流出につながるため、最優先で確認してください。
既存のストレージのままAIを入れると何が起きるか
整備をせずに導入した場合に、実際に起きる問題を具体的に挙げます。着手前に知っておくと、優先順位が決まります。
ここでは4つ挙げます。
見えてはいけない文書が回答に出る
最も重大な事故です。権限の設定が甘いフォルダに機微な文書が置かれていると、AIがそれを読んで回答します。
「アクセス権はあるが、誰も存在を知らなかった」文書が、検索によって表に出てきます。気づかないまま運用が続くと、影響が広がります。
対策は、AIに読ませる範囲を限定することです。全社のファイルサーバーをそのまま対象にせず、確認した範囲だけを読ませる構成にしてください。
古い情報が最新として返る
廃止された手順書をもとに、AIが「こう対応してください」と回答する状態です。回答の形式が整っているため、誤りに気づきにくくなります。
参照した文書の名前と更新日を回答に含める設定にすると、利用者が判断できます。根拠を示さない回答は、確認のしようがありません。
同じ質問に違う答えが返る
同じ内容の文書が複数あり、それぞれ記載が微妙に違う場合、参照する文書によって回答が変わります。利用者は、どちらが正しいのか判断できません。
この状態が続くと、AIへの信頼が失われます。一度「当てにならない」と判断されると、使われなくなります。
文書の形式が読み取れない
紙をそのまま画像として保存したPDF、複雑に結合されたセルの表、図の中に文字が書かれた資料。これらは読み取りの精度が下がります。
内容としては重要な文書ほど、こうした形式で保存されている場合があります。読ませたい文書が読める形式かを、事前に確認してください。
なお、読み取れない文書は「回答に含まれない」という形で表れます。誤った回答より発見が遅れるため、参照できている文書の一覧を確認する工程を入れておいてください。入れたつもりの文書が実は読まれていなかった、という状況は起こり得ます。
| データ整備や権限設計の見直しを、伴走して支援しています。 >> 相談予約はこちら |
データ整備の進め方5ステップ
全社のファイルを一度に整理しようとすると、着手できないまま終わります。範囲を絞って進めてください。
ここでは5つのステップに分けて説明します。
ステップ1|対象業務と質問を絞る
どの業務のどんな質問に答えさせたいかを決めます。「社内規程について答える」「製品仕様の問い合わせに答える」といった単位です。
対象が決まれば、読ませる文書の範囲も決まります。全社の文書を対象にする必要はありません。
ステップ2|読ませる文書を選ぶ
対象業務に関係する文書を洗い出し、その中から最新かつ正しいものを選びます。古い版、下書き、個人が作った参考資料は除外します。
この選別が、回答の質を最も左右します。量を増やすより、確実に正しいものだけを入れるほうが結果は安定します。
ステップ3|権限を確認する
選んだ文書について、誰が見てよいかを確認します。利用者ごとに見える範囲を変える必要があるなら、その仕組みも設計します。
全員が同じ範囲を見てよい文書だけに絞る、という選択もあります。権限の切り分けが複雑になるなら、まず共通の文書から始めるほうが早く進みます。
ステップ4|形式を整える
読み取りにくい形式の文書を、扱える形に変換します。画像として保存されたPDFは文字として読める形にし、複雑な表は構造を整理します。
すべてを直す必要はありません。重要な文書から順に、必要な範囲だけ対応してください。
整備にかかる工数の目安
「整備が必要」と分かっても、どれだけの手間がかかるかが見えないと着手できません。おおよその目安を示しておきます。
対象を1つの業務に絞り、読ませる文書が100件程度であれば、選別と権限の確認に数日から2週間程度が目安になります。このうち最も時間がかかるのは、どれが最新版かを判断する作業です。
文書の形式を整える作業は、対象の状態によって大きく変わります。すでに文字として読める形式であれば不要ですが、紙をそのまま取り込んだ資料が多い場合は別途の作業が発生します。
最初の1業務で手順を確立すれば、2つ目以降は短くなります。全社に広げる前提であっても、まず1つで型を作ってください。
ステップ5|更新の仕組みを決める
文書が更新されたとき、AIが参照する内容にどう反映するかを決めます。手作業で入れ替えるのか、自動で同期するのかで運用の負担が変わります。
あわせて、古くなった文書を除く担当も決めてください。入れる仕組みだけあって出す仕組みがないと、時間とともに精度が下がります。
保存すべきデータの判断
AIの活用が広がると、データの価値も変わります。これまで捨てていた記録が、資産として見直される場面があります。
ここでは3つの観点で整理します。
価値が上がったデータ
過去の問い合わせ対応の記録、失注した案件の理由、トラブルの対処履歴。これらは、これまで参照されにくい記録でした。
AIが横断的に検索できるようになると、こうした蓄積が使える形になります。過去の似た事例を探し出し、対応の参考にするといった使い方が現実的になりました。
「いつか使うかもしれない」で残していた記録が、実際に使える段階に入っています。
増え続けるデータへの対応
一方で、すべてを残せば容量と費用が増え続けます。とくに動画や音声の記録は、量に対して情報の密度が低くなりがちです。
会議の録画そのものより、文字起こしと要約を残すほうが、容量も検索性も有利になります。元の記録は一定期間で削除するという運用も選択肢です。
保存期間の考え方
法令で保存期間が定められている文書は、その期間を守ります。それ以外は、実際に参照される頻度から判断してください。
何年も誰も開いていない文書は、AIの参照範囲からも外す候補になります。残すこと自体は問題ありませんが、AIに読ませる対象とは分けて考えます。
この切り分けは、保管用の領域とAIに読ませる領域を分ける形で実現できます。保管はしておくが参照はさせない、という状態を作れると、削除の判断に悩む必要がなくなります。捨てるかどうかと、読ませるかどうかは別の問題です。
| データ基盤の整備や社内文書の活用について、資料でご確認いただけます。 >> 資料請求はこちら |
選定・設計時の確認事項
製品やサービスを選ぶ際、あるいは構成を設計する際に確認すべき点を整理します。
ここでは5つ挙げます。
データの保管場所と管轄
データがどの国に保存されるかを確認します。海外に保存される場合、扱う情報の種類によっては追加の検討が必要になります。
個人情報を含む場合は、越境してデータを移転することの扱いを事前に確認してください。契約と社内規程の両面から判断します。
既存の権限設定を引き継げるか
現在のファイルサーバーやクラウドストレージで設定している権限を、AIの参照範囲にも反映できるかを確認します。
別途で権限を設定し直す必要がある構成では、運用の負担が二重になります。人事異動のたびに両方を直すことになり、いずれ食い違いが生じます。
入力内容の取り扱い条件
文書の内容が学習に使われないか、どこに保存されるかを利用規約で確認します。設定で切り替えられるだけでなく、規約に明示されているかを見てください。
社内文書を扱う以上、この確認は必須です。組織で使ってよいサービスの条件として、あらかじめ定めておくと判断がぶれません。
参照範囲を柔軟に変えられるか
AIに読ませる対象を、フォルダ単位や文書単位で指定できるかを確認します。全部か何もなしかという設定しかできないと、段階的な導入ができません。
最初は限られた範囲から始め、問題がないことを確認してから広げるのが安全な進め方です。この進め方ができる構成かどうかは、選定時の判断材料になります。
あわせて、後から特定の文書を除外できるかも確認してください。運用を始めてから「この文書は読ませたくなかった」と気づく場面があります。
将来の移行のしやすさ
蓄積したデータを取り出せるか、別の仕組みに移せるかを確認します。特定のサービスに固定されると、後から選択肢がなくなります。
とくに、整備に手間をかけたメタデータや構造が引き継げるかは重要です。やり直しになると、投資した時間が失われます。
これからの見通し
最後に、今後の方向性を整理します。判断のタイミングを考えるうえでの参考にしてください。
3つの観点で見ていきます。
整備されたデータの価値が上がる
AIの性能が上がるほど、参照するデータの質が結果を左右します。同じモデルを使っても、読ませるデータで差がつく構造です。
モデルは誰でも同じものを使えますが、自社のデータは他社にありません。ここが差別化の源になります。
権限管理の重要性が増す
AIが横断的に検索するようになると、権限の設定漏れが表面化しやすくなります。これまで問題にならなかった曖昧さが、事故につながります。
AI導入をきっかけに、権限設計を見直す企業が増えています。これは負担ではなく、本来やるべき整理を進める機会と捉えられます。
実際、権限やフォルダ構成の整理は、必要性が分かっていても後回しにされがちな作業です。AI導入という具体的な目的があると、着手する理由と予算が立てやすくなります。整理そのものが目的では動かない組織でも、この機会なら進められる場合があります。
判断は自社の状況から始める
高性能なストレージ基盤が必要かどうかは、モデルを自社で学習させるかで決まります。該当しないなら、投資すべきはデータの整備です。
製品の性能比較から入らず、自社が何をしたいかから考えてください。多くの場合、必要なのはハードウェアではなく整理の作業です。
業務でのAI活用を広く整理した内容は、業務効率化アイデア55選|部門別30+AI15+明日から3つで成果を出す方法でも紹介しています。他のコラム記事はネクストスケールのブログ一覧からご覧いただけます。
まとめ
「AIストレージ」は、AI学習向けの高性能な基盤と、AIに読ませるデータの置き場という2つの意味で使われています。自社がどちらを必要としているかを、まず切り分けてください。
モデルを自社で学習させる企業は限られます。既存のAIサービスを使うのであれば、高性能な基盤は不要で、必要なのはデータの整備です。
整備で押さえるのは、検索性、権限、鮮度、形式の4点です。とくに権限の設計は最優先で確認してください。AIが横断的に検索することで、これまで表に出なかった文書が回答に現れる可能性があります。
進め方は、対象業務を絞る、読ませる文書を選ぶ、権限を確認する、形式を整える、更新の仕組みを決めるの5ステップです。全社のファイルを一度に整理しようとせず、範囲を区切って進めてください。
そして、モデルは誰でも同じものを使えますが、自社のデータは他社にありません。整備に投じた手間は、そのまま差になって表れます。
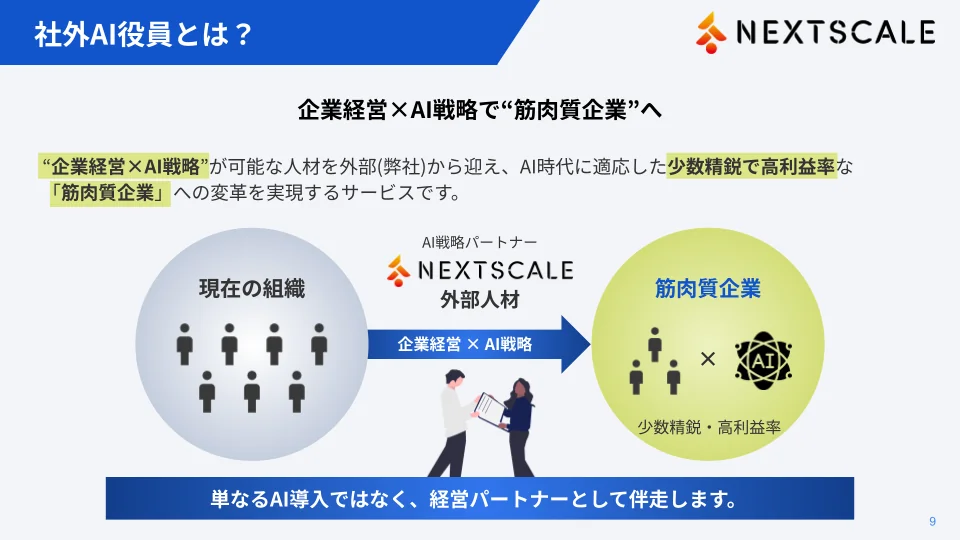
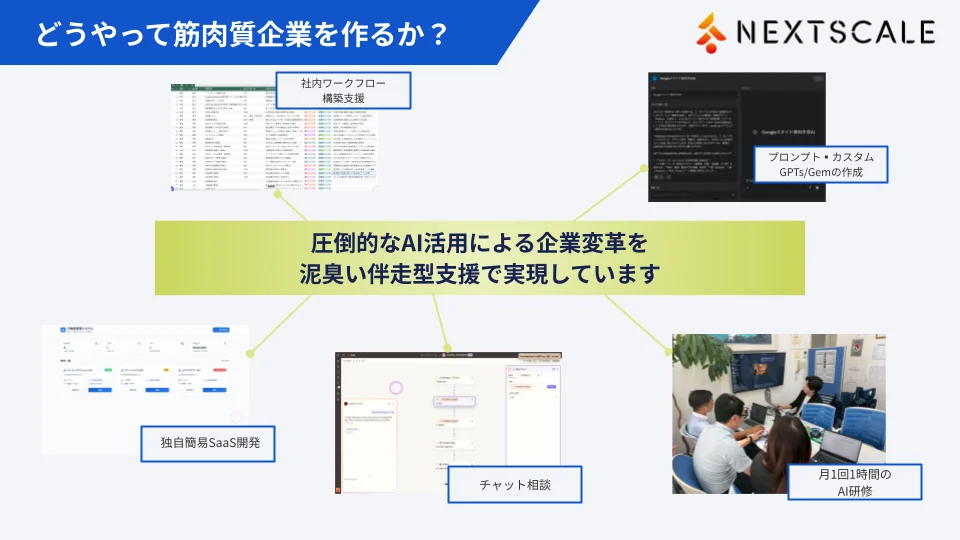
AIコンサル・AX伴走支援サービスご紹介資料
この資料でこんなことがわかります!
- 社外AI役員とは
- 支援内容
- 導入の進め方
- 導入実績・効果
\3ステップで簡単入力/
| AI活用に向けたデータ整備を、どこから・どの順番で進めるべきか。現状を伺ったうえで、具体的な進め方をご提案します。 >> 相談予約はこちら |
この記事の監修者
株式会社ネクストスケール 代表取締役

関連記事
-
 AI受託開発とは?依頼できること・費用相場・開発会社の選び方と成功のポイントを解説
-
AI開発のPoCとは?進め方・費用・成功のポイントと「PoC止まり」を防ぐ方法を解説
-
バイブコーディングとは?やり方・おすすめツールとメリット・注意点を解説【2026年最新】
-
AIアプリおすすめ15選|無料で使える目的別の選び方と業務利用の注意点【2026年最新】
-
AIを活用したアプリ開発とは?手順・費用・おすすめツールまで解説
-
AIアプリ開発の費用相場は?内訳・種類別の目安と費用を抑える方法
-
AIアプリ開発をノーコードで実現!おすすめツールと進め方を解説
-
AIプロダクト開発の進め方とは?手順・開発手法・成功のポイントを解説