Whisperで無料文字起こしする方法 モデルの選び方と精度、導入手順と注意点
 2026年9月16日
 著者:NEXT SCALE編集部
監修者:石丸真平
「会議の録音を文字起こししたいが、有料サービスは費用がかかる」「機密情報を含む音声を外部のサービスへアップロードするのは避けたい」。こうした場面で候補に挙がるのがWhisperです。
WhisperはOpenAIが公開している音声認識モデルで、オープンソースとして提供されています。自分のパソコンで動かせば、費用をかけずに文字起こしができます。
この記事では、無料で使う3つの方法、モデルの選び方、導入の手順、精度を上げるコツ、そして業務で使う際の注意点までを整理します。専門的な知識がなくても進められる形で解説します。
| 確認したいポイント | 結論 | 詳細 |
|---|---|---|
| Whisperは無料で使える? | 自分の環境で動かせば無料 | オープンソースとして公開されており、モデルの利用に費用はかかりません。 |
| どうやって使う? | ローカル導入かクラウド実行 | パソコンにインストールする方法と、ブラウザ上で動かす方法があります。 |
| 日本語の精度は? | 実用水準だが誤変換は残る | 固有名詞や専門用語は誤りやすく、修正の工程は前提になります。 |
| 機密情報は扱える? | 自分の環境内で処理すれば可能 | 外部へ送らずに済むことが、有料サービスに対する最大の利点です。 |
この記事でわかること
- Whisperが無料で使える理由と、有料のAPIとの違い
- ローカル導入、クラウド実行、既製ツールという3つの利用方法
- 6種類のモデルの違いと、用途に応じた選び方
- 導入から実行までの5ステップと、精度を上げる5つのコツ
- 業務で使う際に押さえるべき注意点と、有料サービスとの使い分け
| 業務の効率化を具体的に進めたい方へ AIを使った業務自動化の進め方と、社内で回し続ける体制づくりをまとめたサービス資料を無料で配布しています。 ▶ 資料請求はこちら |
 こんな方におすすめ

WhisperはOpenAIが公開している音声認識モデル
Whisperは、ChatGPTで知られるOpenAIが開発し、オープンソースとして公開している音声認識モデルです。音声データをテキストへ変換する機能を提供します。
特筆すべきは、この性能のモデルが無償で公開されている点です。誰でもダウンロードして自分の環境で動かせるため、利用そのものに費用がかかりません。
多言語に対応しており、日本語の音声も扱えます。まずは無料で使える範囲と、有料の選択肢との違いを確認します。
無料で使える範囲と有料のAPIの違い
Whisperの利用方法は、大きく2つに分かれます。どちらを選ぶかで、費用とデータの扱いが変わります。
- 自分の環境で動かす:モデルをダウンロードして実行する。費用はかからず、音声も外部へ送らない
- APIを利用する:OpenAIのサービスとして呼び出す。処理時間に応じた費用が発生し、音声は外部へ送信される
無料で使いたい場合、選ぶのは前者です。ただし、環境を用意する手間と、パソコンの性能に処理速度が左右される点は前提になります。
APIは手軽ですが、大量の音声を処理する場合は費用が積み上がります。件数が多い業務では、自前で動かすほうが結果的に安くなります。
判断の目安は、月に処理する音声の総時間です。数時間程度ならAPIで十分ですが、数十時間を超えるなら環境を用意する価値が出てきます。
日本語の精度と得意な場面
日本語の文字起こしにも対応しており、実用に足る水準の精度が出ます。雑音が混ざる環境や、複数の人が話す音声でも一定の結果を返します。
一方で、誤変換は必ず残ります。社名、商品名、業界特有の用語などは、音が近い別の言葉に置き換わることがよくあります。
そのまま使える成果物ではなく、修正を前提とした下書きとして捉えてください。それでも、ゼロから聞き取って入力する作業と比べれば大幅な短縮になります。
期待する精度をあらかじめ共有しておいてください。完璧な文字起こしを想定していると、修正作業が発生した時点で使われなくなります。
最大の利点は音声を外部へ送らずに済むこと
会議、面談、インタビューの録音には、社外に出せない情報が含まれることがあります。クラウド型のサービスでは、こうした音声を外部のサーバーへ送ることになります。
自分の環境で完結させられる点は、業務利用では大きな価値になります。インターネット接続がない状態でも動作するため、通信環境の制約がある場所でも使えます。
Whisperを無料で使う3つの方法
利用の方法は複数あります。技術的な知識の有無と、扱う音声の性質によって、適した方法が変わります。
ここでは手軽な順に3つ紹介します。
方法1|自分のパソコンにインストールする
最も自由度が高く、業務利用に適した方法です。一度環境を整えれば、何時間分の音声でも追加費用なしで処理できます。
必要になるのは、Pythonの実行環境と音声変換のツールです。コマンドを入力する操作に抵抗がなければ、30分程度で準備できます。
パソコンの性能によって処理時間が大きく変わる点は注意が必要です。グラフィック処理用の装置を搭載していれば高速ですが、そうでない場合は音声の長さの数倍の時間がかかることもあります。
方法2|クラウド上の実行環境を使う
ブラウザ上でプログラムを実行できるサービスを使えば、自分のパソコンに何もインストールせずに試せます。無料の範囲でも高性能な処理装置を使える場合があります。
手元の環境が非力な場合や、まず精度を確かめたい段階に向いています。準備の手間が少なく、数分で試せる点が利点です。
ただし、音声ファイルをクラウド上へアップロードすることになります。機密性の高い音声には使わないでください。
方法3|Whisperを組み込んだ既製ツールを使う
コマンド操作が不要で、画面上でファイルを選ぶだけで文字起こしできるツールも公開されています。技術的な準備をせずに使い始められます。
無料で配布されているものもありますが、提供元と処理の方法を確認してください。見た目は手元で動いていても、実際には外部へ送信している場合があります。
業務で使う場合は、処理がどこで行われるかを必ず確認してください。ここが不明なツールは、機密情報を含む音声には使わないという判断が安全です。
| 自社での活用方法を相談したい方へ 扱う音声の内容と件数を伺い、自前で動かすべきか既製サービスを使うべきかを整理します。30分のオンライン相談は無料です。 ▶ 相談予約はこちら |
 サービス資料をダウンロードする
モデルの種類と選び方
Whisperには複数のモデルが用意されており、大きさによって精度と速度が変わります。ここを理解しておかないと、遅すぎる、または精度が足りないという結果になります。
大きいモデルほど精度は上がりますが、処理は遅く、必要なメモリも増えます。用途に応じた選択が必要です。
6つのモデルの違い
OpenAIの公式リポジトリでは、モデルのパラメータ数、必要なVRAM、相対的な速度が一覧で示されています。tinyは39M(約1GB、約10倍速)、baseは74M(約1GB、約7倍速)、smallは244M(約2GB、約4倍速)、mediumは769M(約5GB、約2倍速)、largeは1550M(約10GB、1倍速)、turboは809M(約6GB、約8倍速)とされています。turboはlarge-v3を最適化したもので、精度の低下を最小限に抑えつつ高速な文字起こしを実現すると説明されています(出典:OpenAI「Whisper」公式リポジトリ https://github.com/openai/whisper )。
日本語を扱う場合は、英語専用のモデルではなく多言語対応のものを選んでください。名前の末尾にenが付いているものは英語専用です。
用途に応じた選び方
迷ったときの目安を整理します。
- 動作の確認や短いメモ:tinyまたはbase。速いが日本語の誤認識は目立つ
- 日常的な記録:small。処理速度と精度のバランスが取れている
- 議事録など業務文書:mediumまたはturbo。実用に足る精度が得られる
- 最高精度が必要な場面:large。ただし処理時間とメモリの負担が大きい
業務利用ではturboが有力な選択肢になります。largeに近い精度を保ちながら、処理が大幅に速いためです。
ただし、turboは翻訳の用途には対応していないとされています。音声を別の言語へ変換したい場合は、mediumまたはlargeを選んでください。
まず小さいモデルで試す
最初から大きいモデルを使うと、処理が終わらずに環境の問題なのか設定の誤りなのかが判断できません。
まずsmallで動作を確認し、精度が足りなければ段階的に上げていく進め方が確実です。音声の一部だけで試せば、比較にかかる時間も短くて済みます。
比較には、自社で実際に扱う音声を使ってください。きれいに録音されたサンプルで試しても、本番での精度はわかりません。
パソコンへの導入から実行までの5ステップ
ここではWindowsやMacのパソコンに導入する流れを解説します。コマンドを入力する操作が中心になりますが、手順は決まっています。
所要時間は、通信環境にもよりますが30分程度です。
STEP1 Pythonを準備する
Whisperを動かすには、Pythonという実行環境が必要です。公式サイトから入手してインストールします。
インストール時に、パスを通す設定にチェックを入れてください。ここを忘れると、後の手順でコマンドが認識されません。
すでにPythonが入っている場合でも、バージョンによっては動かないことがあります。うまくいかないときは、対応するバージョンを確認してください。
STEP2 FFmpegを導入する
音声や動画のファイルを扱うためのツールです。これがないと、多くの形式のファイルを読み込めません。
導入後、コマンドでバージョン情報が表示されれば成功です。表示されない場合は、パスの設定を確認してください。
STEP3 Whisperをインストールする
コマンドを1行実行するだけで、必要なファイルが自動的に取得されます。関連する部品も併せて導入されるため、数分かかることがあります。
他のプログラムとの競合を避けたい場合は、専用の環境を作ってからインストールしてください。同じパソコンで別の作業をしている場合、影響を与えずに済みます。
STEP4 コマンドで文字起こしを実行する
音声ファイルの場所と、使うモデル、言語を指定して実行します。初回はモデルのダウンロードが発生するため、時間がかかります。
言語の指定は必ず行ってください。指定しないと自動で判定されますが、誤った言語として処理されることがあります。
最初は短い音声で試してください。1時間分をいきなり処理すると、設定を間違えていた場合に時間を無駄にします。数分の音声で動作を確認してから本番に移ります。
STEP5 出力形式を指定する
結果はテキストファイルとして保存されます。指定すれば、字幕用の形式や、時刻情報を含む形式でも出力できます。
出力先のフォルダーも指定できます。処理する音声が多い場合は、保存場所を整理しておかないと後で探せなくなります。
動画の字幕に使う場合は字幕形式、議事録に使う場合はテキスト形式というように、用途に応じて選んでください。
時刻情報が入っていると、後から該当箇所の音声を確認したいときに便利です。修正作業の効率が変わります。
文字起こしの精度を上げる5つのコツ
モデルを大きくする以外にも、精度を改善する方法があります。特に録音の段階での工夫は効果が大きくなります。
ここでは実践しやすい5つを挙げます。
コツ1|録音の質を上げる
精度を最も左右するのは、モデルの性能ではなく元の音声の質です。雑音が少なく、話し手の声が明瞭に入っている音声であれば、小さいモデルでも実用的な結果が出ます。
会議では、参加者の近くにマイクを置いてください。部屋の端に置いた1台で全員の声を拾おうとすると、遠い人の発言が聞き取れなくなります。
空調の音、キーボードの打鍵音、資料をめくる音なども精度を下げる要因です。可能な範囲で減らしてください。
コツ2|言語を明示的に指定する
自動判定に任せると、日本語の音声が別の言語として処理されることがあります。特に冒頭が無音だったり、英語の固有名詞から始まったりする場合に起こります。
日本語だと明示するだけで、この種の失敗は防げます。手間はほとんどかかりません。
コツ3|長い音声は分割する
数時間に及ぶ音声を一度に処理すると、時間がかかるうえに途中で失敗する可能性も上がります。30分程度に区切って処理するほうが安定します。
分割しておくと、精度が低かった部分だけをやり直せる点も利点です。全体を最初から処理し直す必要がなくなります。
コツ4|固有名詞は後からまとめて置換する
社名、人名、商品名、業界用語は誤変換されやすい項目です。ただし、同じ誤りが繰り返される傾向があります。
よく出る誤変換の対応表を作っておくと、修正が一括で済みます。議事録のように同じ用語が繰り返し出る文書では、この方法が特に効きます。
コツ5|生成AIで整形する
文字起こしの結果は、話し言葉のまま出力されます。フィラーや言い直しが残るため、読みやすい文章にするには整形が必要です。
この工程は生成AIに任せられます。要約、話し言葉から書き言葉への変換、決定事項の抽出まで短時間で処理できます。
整形の指示は定型として保存しておいてください。毎回同じ形式で出力させれば、後から読む側も内容を追いやすくなります。
録音から整形、共有までの流れを仕組みにしたい場合は、AI業務自動化・GAS開発のサービス内容もあわせてご確認ください。
| 業務への組み込みを検討したい方へ どの業務にどれだけの効果が見込めるか、判断材料をまとめた資料をご用意しています。稟議の参考資料としてもご活用いただけます。 ▶ 資料請求はこちら |
用途別に見るWhisperの活かし方
同じ文字起こしでも、何に使うかで求められる精度も後工程も変わります。用途に応じた進め方を整理します。
共通するのは、出力をそのまま使わず後工程を設計しておくことです。ここまで含めて初めて、業務としての効率化になります。
会議の議事録|要約と決定事項の抽出まで含める
録音をそのままテキストにしても、量が多くて読まれません。文字起こしの後に、要約と決定事項、次のアクションを抽出する工程を組み込んでください。
発言者の区別ができないため、誰の発言かを残したい場合は、録音時に名前を呼んでから話す運用にするといった工夫が必要になります。
インタビューや取材|時刻情報を残す
後から特定の発言を確認する場面が多いため、時刻情報を含む形式で出力してください。該当箇所の音声にすぐ戻れる状態になります。
引用として使う場合は、必ず音声と照合してください。言い回しの細かい違いが、意味を変えることがあります。
動画の字幕|字幕形式で出力する
字幕用の形式で出力すれば、動画編集のソフトへそのまま読み込めます。表示のタイミングも自動で設定されます。
1行あたりの文字数は調整が必要です。自動生成されたままでは長すぎることがあり、読み切れないまま次の字幕へ切り替わります。
問い合わせ対応の記録|蓄積して分析に使う
電話対応の録音をテキスト化して蓄積すると、よくある質問の傾向が見えてきます。FAQの整備やマニュアルの改善につなげられます。
顧客の個人情報が含まれるため、処理する環境と保管の方法は必ず社内で決めてから始めてください。
業務で使う際に押さえる4つの注意点
無料で高性能という利点の裏に、押さえておくべき制約もあります。先に知っておけば、想定外の問題を避けられます。
ここでは4つに整理します。
注意1|機密情報の扱いを社内で決めておく
自分の環境で処理する限り、音声が外部へ送られることはありません。ただし、クラウド上で実行する場合やツールを経由する場合は、送信先を確認する必要があります。
どの音声をどの方法で処理してよいかを、事前に明文化してください。個人の判断で使い始める状況を放置すると、機密性の高い音声が外部へ出る可能性があります。
社内規程で外部サービスの利用が制限されている場合もあります。情報システム部門に確認してから導入を進めてください。
録音そのものについても確認が必要です。会議やインタビューを記録する際は、参加者への事前の同意を得る運用にしてください。
注意2|存在しない文章が生成されることがある
無音の区間や聞き取りにくい部分で、実際には話されていない内容が出力される現象が起こります。文章として自然なため、読んだだけでは気づけません。
重要な記録として使う場合は、音声と照合する工程を残してください。特に数値や固有名詞は、確認が欠かせません。
この現象の仕組みと対策については、AIのハルシネーションとは|原因と発生する仕組み、事例と対策で詳しく解説しています。
注意3|話者の識別はできない
誰が話したかを区別する機能は含まれていません。出力されるのは、発言の内容が続けて並んだテキストです。
複数人の会議で発言者を分けたい場合は、別の仕組みを組み合わせる必要があります。この用途を重視するなら、専用のサービスを検討してください。
注意4|処理時間はパソコンの性能に左右される
グラフィック処理用の装置がない環境では、1時間の音声に数時間かかることもあります。急ぎの業務には向きません。
夜間に処理させる運用にすれば、この制約は緩和できます。翌朝には結果が揃っている状態をつくれます。
複数のファイルをまとめて処理する指定もできます。1件ずつ実行する手間がなくなり、放置しておける時間を活かせます。
有料サービスとの使い分け
無料で使えることは大きな利点ですが、すべての場面で最適とは限りません。どこで線を引くかを整理します。
判断の軸は、量、急ぎ具合、求める機能の3つです。
APIを使うべき場面
環境を用意する手間をかけたくない場合や、自分のパソコンの性能が不足している場合は、APIの利用が現実的です。処理は外部で行われるため、手元の環境に依存しません。
費用は処理時間に応じて発生します。月に数時間程度であれば、負担にならない金額に収まることが多くなります。
専用の文字起こしサービスを使うべき場面
話者の識別、音声との同期再生、共同編集といった機能が必要な場合は、専用のサービスが適しています。文字起こしの後の作業まで含めて設計されているためです。
使う人が複数いる場合も、専用サービスのほうが向きます。全員にコマンド操作を覚えてもらうのは現実的ではありません。
使い分けの判断基準
次の条件に当てはまるなら、自分の環境で動かす方法が適しています。
- 外部に出せない音声を扱う
- 処理する音声の量が多く、費用を抑えたい
- 急ぎではなく、夜間などに処理させられる
- 文字起こしの後は自分で編集する
反対に、少量を急いで処理したい、複数人で使いたい、話者の識別が必要という場合は、有料の選択肢を検討してください。
両方を併用する判断も有効です。機密性の高い音声は手元で、急ぐものは有料サービスでというように、性質に応じて使い分けてください。
社内でAIを使いこなす体制づくりは、法人向けAI研修のサービス内容が参考になります。
| 音声業務の効率化を伴走支援します 業務の棚卸しから手段の選定、現場への定着、効果測定までを一気通貫でご支援しています。まずは現状の課題整理からご相談ください。 ▶ 相談予約はこちら |
まとめ|まずsmallで試し、用途に応じてモデルを上げる
WhisperはOpenAIがオープンソースとして公開している音声認識モデルです。自分の環境で動かせば費用はかからず、音声を外部へ送らずに処理できます。
使う方法は、パソコンへの導入、クラウド上での実行、既製ツールの利用の3つです。機密性の高い音声を扱うなら、手元で完結する方法を選んでください。
モデルはtinyからlargeまで用意されており、業務利用ではturboかmediumが現実的な選択になります。まずsmallで動作を確認し、精度が足りなければ上げていく進め方が確実です。
そして、精度は録音の質に大きく左右されます。マイクの位置と雑音の除去という基本を押さえるだけで、結果は大きく変わります。
他社がどのような順番で業務を効率化したのかは、ネクストスケールの導入事例でご覧いただけます。
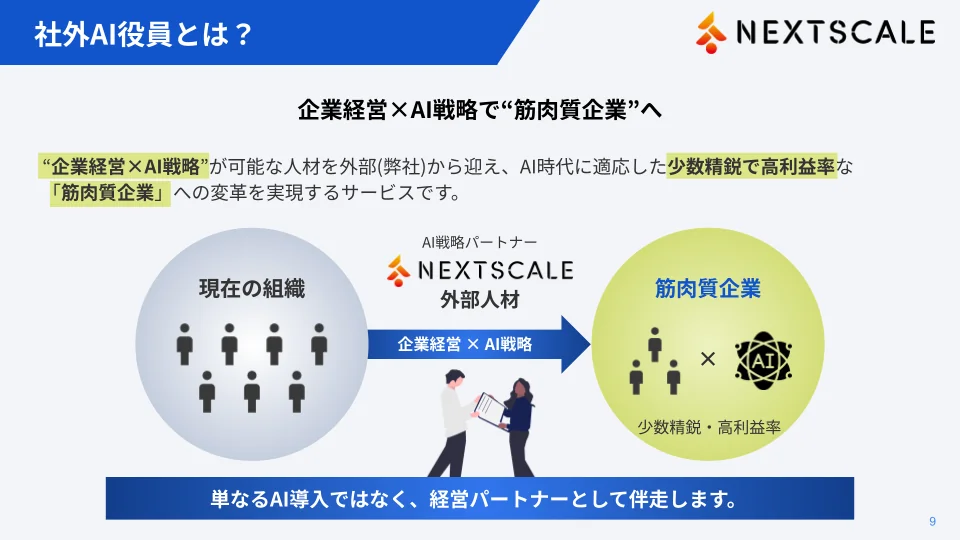
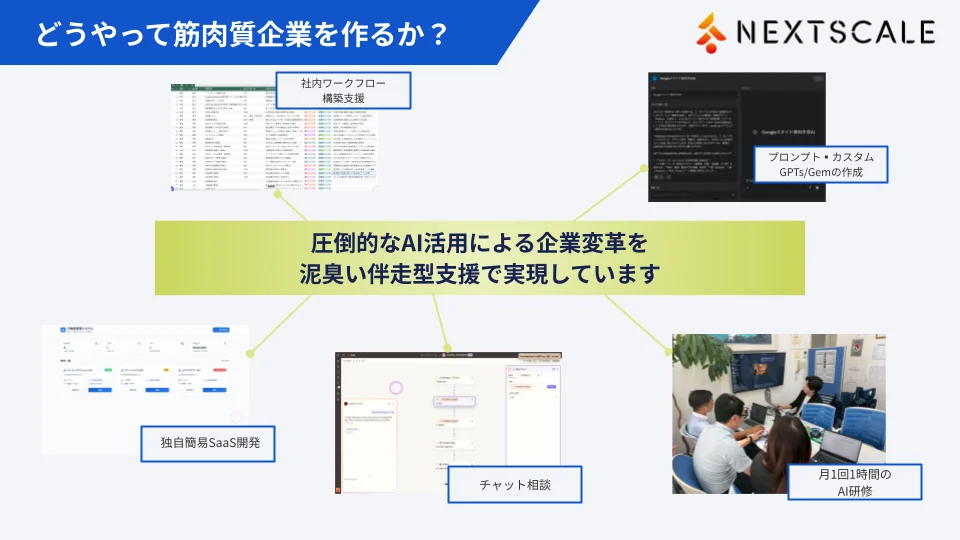
AIコンサル・AX伴走支援サービスご紹介資料
この資料でこんなことがわかります!
- 社外AI役員とは
- 支援内容
- 導入の進め方
- 導入実績・効果
\3ステップで簡単入力/
| AI活用の進め方を無料でご提案します 貴社の業務を伺い、どこから着手すべきかを無料でご提案します。オンライン30分で完結し、助成金活用のご相談も歓迎しています。 ▶ 相談予約はこちら |
この記事の監修者
株式会社ネクストスケール 代表取締役

関連記事
-
 AI在庫管理とは?仕組み・メリット・活用事例と導入のポイントを解説
-
業務効率化ツールとは?目的別の選び方・おすすめカテゴリ・導入のコツを徹底解説
-
業務効率化ソリューションとは?種類・選び方・導入手順と2026年の注目トレンドを解説
-
業務効率化の相談先はどこ?専門家の選び方・無料窓口・依頼時のポイントを解説
-
RPAで業務効率化を実現するには?導入メリット・活用事例・ツール選びと注意点を解説
-
ワークフローで業務効率化を実現するには?導入メリット・ツール選び・成功事例を解説
-
クラウドで業務効率化を実現するには?メリット・ツール選び・導入手順と注意点
-
経理の業務効率化とは?課題・具体的な方法・ツール・AI活用と成功事例を解説