AIのハルシネーションとは 原因と発生する仕組み、事例と業務での対策6つを解説
 2026年9月15日
 著者:NEXT SCALE編集部
監修者:石丸真平
「AIが出してきた資料に、存在しない出典が入っていた」「もっともらしく書かれていたので気づかず提出してしまった」。生成AIを業務で使い始めた企業から、こうした相談が増えています。
原因はハルシネーションと呼ばれる現象です。AIが事実に基づかない内容を、自然な文章としてつくり出してしまうことを指します。文章として破綻していないため、読んだだけでは誤りに気づけません。
この記事では、ハルシネーションが起こる仕組みと原因を整理したうえで、実際の事例、業務上のリスク、そして現場で実行できる6つの対策をまとめます。組織として整えるべきルールについても解説します。
| 確認したいポイント | 結論 | 詳細 |
|---|---|---|
| ハルシネーションとは? | 事実でない内容をもっともらしく出力する現象 | 日本語では幻覚と訳されます。存在しない論文や判例、誤った数値を自信を持って提示します。 |
| なぜ起こるのか? | 次に来る言葉を予測する仕組みによるもの | AIは事実を検索しているのではなく、自然につながる文章を組み立てています。 |
| 完全に防げるのか? | 現時点では完全な防止はできない | 技術的な改善は進んでいますが、発生を前提に確認工程を用意することが現実的な対応です。 |
| 最も効く対策は? | 根拠を示させ、人が確認すること | 出典を提示させる指示と、数値や固有名詞を人が検証する工程で大半の事故は防げます。 |
この記事でわかること
- ハルシネーションの定義と、内在的・外在的という2つの種類の違い
- AIが事実でない内容を出力してしまう5つの原因と、その背景にある仕組み
- 実際に起きている代表的な事例と、業務で生じる3つのリスク
- 発生を抑えるために現場で実行できる6つの対策
- 組織としてガイドラインや確認体制を整えるときに決めるべき項目
| 生成AIを安全に業務へ導入したい方へ リスク対策を含めたAI活用の進め方と、社内で回し続ける体制づくりをまとめたサービス資料を無料で配布しています。 ▶ 資料請求はこちら |
 こんな方におすすめ

ハルシネーションとは事実でない内容をもっともらしく出力する現象
ハルシネーションとは、生成AIが事実に基づかない情報を、あたかも正しいかのように出力してしまう現象のことです。英語のhallucinationに由来し、日本語では幻覚と訳されます。
実在しない論文のタイトル、存在しない判例、誤った数値や日付。こうした内容が、自然で説得力のある文章として提示されます。文章が整っているほど、読み手は誤りを疑いません。
まずは公的な整理を確認したうえで、種類の違いと、なぜ気づきにくいのかを順に見ていきます。
公的資料でもリスクとして明記されている
総務省「令和6年版 情報通信白書」では、生成AIが事実に基づかない誤った情報をもっともらしく生成することをハルシネーション(幻覚)と呼ぶと説明されています。そのうえで、技術的な対策は検討されているものの完全に抑制できるものではないため、生成AIを活用する際は発生の可能性を念頭に置き、検索を併用するなど、出力した答えが正しいかどうかをユーザーが確認することが望ましいとされています(出典:総務省「令和6年版 情報通信白書」生成AIが抱える課題 )。
押さえておきたいのは、完全には抑制できないと明記されている点です。ゼロにする方法を探すのではなく、起こる前提で業務を設計するという発想に切り替える必要があります。
同白書では、2024年に総務省と経済産業省が策定したAI事業者ガイドラインにおいて、生成AIによって顕在化したリスクの1つとしてハルシネーションが挙げられていることにも触れられています。
種類は内在的と外在的の2つに分かれる
発生の仕方によって、大きく2つに分類できます。この違いを知っておくと、検出のしやすさも見当がつきます。
- 内在的ハルシネーション:学習した内容と矛盾する出力をする。元の情報と照合すれば比較的見つけやすい
- 外在的ハルシネーション:学習データにない内容を作り出す。照合先がないため発見が難しい
厄介なのは後者です。存在しない論文や統計を提示された場合、その分野に詳しくなければ誤りだと判断できません。検索して初めて見つからないことに気づく、という流れになります。
文章が自然だからこそ気づけない
生成AIは、文脈に合った自然な文章をつくることに長けています。内容の正誤にかかわらず、読みやすく説得力のある形で出力されます。
人は、断定的で整った文章を信じやすい傾向があります。口ごもりながら話す人より、自信を持って言い切る人の言葉を信用してしまうのと同じ構造です。
さらに、正しい情報の中に誤りが1つだけ混ざっているケースが最も危険です。全体の精度が高いほど、部分的な誤りを見逃しやすくなります。
9割が正しい回答は、すべてが間違っている回答より扱いが難しくなります。前半を読んで信用した状態で後半を読むため、警戒心が働かないからです。
ハルシネーションが起こる5つの原因
対策を考える前に、なぜ起こるのかを理解しておく必要があります。原因がわかれば、どの対策がどこに効くのかも見えてきます。
根本には、生成AIが事実を調べているわけではないという事情があります。検索エンジンとは動作の仕組みがまったく異なります。
原因1|次に来る言葉を予測する仕組みそのもの
生成AIは、大量の文章から学習したパターンをもとに、次に続く可能性が高い言葉を選び続けることで文章を組み立てています。事実のデータベースを引いているわけではありません。
そのため、統計的に自然な組み合わせであれば、実在しない内容でも出力されます。もっともらしい書名や著者名が生成されるのは、この仕組みによるものです。
これは欠陥ではなく、設計上の特性です。同じ仕組みが、柔軟な文章生成という利点も生んでいます。特性として受け入れたうえで運用を組む必要があります。
原因2|学習データの範囲と時点に限りがある
モデルが学習しているのは、ある時点までの情報です。それ以降に起きたことや、公開されていない情報については答えようがありません。
それでも質問されると、手持ちの情報から推測して答えを組み立てます。結果として、古い制度や過去の役職者を現在のものとして提示することが起こります。
社内の固有情報も同様です。自社の製品仕様や社内規程は学習されていないため、一般論から推測した内容が返ってきます。
自社について尋ねたときの回答は、特に注意が必要です。一般的な業界の慣行をもとに組み立てられた内容が、自社の実態として提示されることがあります。
原因3|学習データに誤りや偏りが含まれている
学習に使われる情報の中には、誤った記述や古い情報も混ざっています。ネット上に広く流布している誤情報があれば、それを正しいものとして学習する可能性があります。
特定の立場に偏った情報が多い領域では、出力も偏ります。AIが中立であるとは限らないという前提で読む姿勢が求められます。
原因4|指示が曖昧で推測の余地が大きい
プロンプトが漠然としていると、AIは足りない部分を推測で補います。この補完が事実に基づかない場合、そのまま誤った出力になります。
前提条件、対象範囲、時点を指定しないまま質問すると、この余地が広がります。指示の書き方は、発生率に直接影響する要素です。
原因5|わからないと答えにくい設計になっている
多くのモデルは、不確かな場合でも何らかの回答を返そうとします。空欄で返すより推測で答えるほうが評価されやすい仕組みが、背景にあると指摘されています。
つまり、黙るより間違えるほうが選ばれやすい構造になっているということです。この点を踏まえ、わからない場合はその旨を答えるよう指示することが、有効な対策の1つになります。
| 自社での安全な活用方法を相談したい方へ 業務内容とリスク許容度を伺い、どこまで任せてよいかの線引きを整理します。30分のオンライン相談は無料で、しつこい営業はいたしません。 ▶ 相談予約はこちら |
 サービス資料をダウンロードする
実際に起きているハルシネーションの事例
抽象的に理解していても、現場では見抜けません。どんな形で現れるのかを具体的に知っておくことが、最初の防御になります。
ここでは、業務で遭遇しやすい4つのパターンを挙げます。
存在しない論文や書籍を出典として提示する
参考文献を尋ねると、それらしい書名、著者名、出版年が返ってきます。しかし検索しても見つからない、というケースは頻繁に起こります。
タイトルの付け方や著者名が本物らしく見えるため、確認せずに引用すると危険です。資料やレポートで出典を示す場合は、必ず自分で原典にあたってください。
実在しない判例や条文を引用する
法務や契約に関する質問では、実際には存在しない判例や、条文番号の誤りが混ざることがあります。海外では、AIが生成した架空の判例を提出して問題になった事例も報じられています。
法令や制度は、条文の表現が1つ違うだけで解釈が変わります。この領域はAIの出力をそのまま使わず、必ず公式の情報源で確認する運用にしてください。
制度は改正されます。学習時点では正しかった内容が、現在は誤りになっているというパターンも起こります。時点の確認も忘れないでください。
企業情報や統計の数値が事実と異なる
売上規模、設立年、市場規模といった数値が、実際とは違う値で提示されることがあります。桁が1つ違う、年度がずれているといった形で現れます。
提案書や社内資料に紛れ込むと、その後の意思決定にまで影響します。数値は出典とセットで確認する習慣をつけてください。
公開情報が少ない企業や、新しい市場ほど誤りが混ざりやすくなります。学習データに十分な情報がない領域では、推測の比重が上がるためです。
社内文書を渡しても誤読して回答する
資料を読み込ませた場合でも、誤りは起こります。表の見出しを取り違える、条件の適用範囲を広げすぎる、複数の記述を混ぜて回答するといったパターンです。
資料を渡したから正確だろうという思い込みは危険です。参照した箇所を示させ、元の記述と突き合わせる工程を残しておく必要があります。
業務で生じる3つのリスク
ハルシネーションが問題になるのは、誤情報が外に出たときです。社内で気づいて止められれば実害はありません。
ここでは、実際に起こりうる影響を3つに整理します。
誤った前提で意思決定してしまう
AIが作成したレポートに誤った数値が含まれていた場合、それを確認せずに判断材料に使うと、前提そのものが崩れます。
市場規模の見積もり、競合の状況、法令上の要件。いずれも判断に直結する情報であり、誤りの影響は資料の修正では済みません。
社外へ出した情報で信用を失う
提案書、記事、問い合わせへの回答など、社外に出る文書に誤りが含まれると、企業としての信頼に関わります。一度出した情報は、訂正しても記録として残ります。
特に問い合わせ対応を自動化している場合は注意が必要です。人が介在しない経路で誤った案内が届くと、気づいたときには件数が積み上がっています。
法的な責任を問われる可能性がある
誤った情報を提供したことによる損害や、権利侵害にあたる内容の公開は、法的責任につながる場合があります。AIが生成したという事情は、免責の理由にはなりません。
公的な資料でも、ハルシネーションに関してAI開発者や提供者への訴訟が起きていることが指摘されています。使う側にも、確認義務があるという前提で運用を設計してください。
| リスク対策を含めた導入の進め方を知りたい方へ 社内ルールの整備、確認体制の作り方、教育の進め方までまとめた資料をご用意しています。稟議の参考資料としてもご活用いただけます。 ▶ 資料請求はこちら |
ハルシネーションを抑える6つの対策
完全になくすことはできませんが、発生率を下げ、発生しても気づける状態をつくることはできます。
対策は、出力させる前の工夫と、出力後の確認の2方向に分かれます。両方を組み合わせることで、実務上は十分に管理できる水準になります。
対策1|プロンプトで範囲と前提を明示する
いつ時点の情報か、どの範囲を対象にするか、どの立場で答えるか。こうした条件を書き込むと、推測で補う余地が狭まります。
加えて、わからない場合は推測せずその旨を答えるよう明記してください。これだけで、無理に答えようとする挙動を抑えられます。
参考にする資料を一緒に渡す方法も効果的です。手元の情報だけで答えるよう条件を付ければ、外部の知識から補完する余地そのものがなくなります。
対策2|根拠と出典を必ず示させる
根拠を求めると、出力の性質が変わります。参照元を示せない内容は書かないという制約が加わるためです。
提示された出典は、必ず自分でたどってください。存在しないURLや書名が返ってくること自体が、誤りを見つける手がかりになります。
対策3|RAGで自社のデータを参照させる
社内規程やマニュアルを検索対象として与え、その内容をもとに回答させる方法です。学習していない社内情報についての推測を防げます。
参照した文書を提示できる仕組みにしておけば、担当者が根拠を確認できます。回答の正しさを追跡できる状態になることが、この方式の価値です。
社内データを根拠に回答させる仕組みの構築は、RAG・LLM開発のサービス内容でご確認いただけます。
対策4|検索を併用して突き合わせる
公的資料でも推奨されている方法です。AIの出力をそのまま受け取らず、検索で裏取りをする習慣をつけます。
複数のモデルに同じ質問をして、回答が一致するかを見る方法も有効です。食い違いが出た部分は、そのまま確認すべき箇所になります。
対策5|人が確認する工程を業務フローに組み込む
確認を個人の心がけに任せると、忙しい時期に必ず抜けます。手順書に確認の工程を書き込み、飛ばせない形にしてください。
確認する箇所は、数値、固有名詞、日付、法令の4つに絞れば十分です。全文を検証しようとすると負荷が大きすぎて、運用そのものが止まります。
対策6|使う業務そのものを選ぶ
最も確実な対策は、誤りが致命傷になる業務でAIに判断を委ねないことです。契約、医療、法務、会計といった領域では、補助的な使い方にとどめます。
一方、たたき台の作成、表現の言い換え、情報の整理といった用途であれば、多少の誤りは確認段階で吸収できます。用途の選び方が、リスク管理の出発点になります。
業務ごとに、任せてよい範囲を一覧にしておくと判断が速くなります。使ってよい業務、条件付きで使える業務、使わない業務の3段階に分けておけば、現場が迷いません。
怪しい出力を見抜くためのチェックポイント
対策を整えても、最後に誤りを止めるのは読む人の目です。どこを見れば異常に気づけるのかを、あらかじめ知っておく必要があります。
経験的に、怪しい出力にはいくつかの共通した特徴があります。ここでは現場ですぐ使える4つの観点を紹介します。
具体的すぎる数値や固有名詞は疑う
桁まで揃った数値、聞き慣れない研究機関名、細かい日付。こうした具体性は説得力を生みますが、同時に生成された可能性も高い箇所です。
一般論として述べられている部分より、細部が具体的な箇所のほうが確認の優先度は高くなります。読み流さず、いったん立ち止まってください。
出典をたどれるかどうかで判断する
URL、書名、論文タイトルが示されている場合は、必ず自分で開いて確認します。存在しない、または内容が違うという時点で、その回答全体を疑う理由になります。
1か所でも作られた出典が見つかったら、他の記述も総点検してください。誤りは単独では起こりにくく、同じ回答の中に複数含まれていることがよくあります。
同じ質問を言い換えて聞き直す
表現を変えて同じ内容を尋ね、回答が一致するかを見ます。毎回違う答えが返ってくる項目は、根拠が不確かである可能性が高くなります。
別のモデルに同じ質問を投げる方法も有効です。手間はかかりますが、重要な数値を扱う場面では割に合う確認方法です。
自分が詳しい分野で精度を試しておく
自社の業界や自分の専門領域について質問すると、AIがどの程度の精度で答えるかが体感できます。誤りの傾向をつかむ練習になります。
この感覚があるかどうかで、知らない分野の回答に対する警戒心も変わります。導入時の研修に組み込むと効果的な取り組みです。
組織として整えるべきルールと体制
個人の注意力に頼った運用は、人数が増えた時点で破綻します。仕組みとして整えておく必要があります。
ここでは、社内で決めておきたい3つの観点を挙げます。
ガイドラインに書くべき項目を決める
長文の規程は読まれません。実務で守れる粒度に絞って、次の項目を明文化してください。
- AIの出力をそのまま社外に出してよい場面と、出してはいけない場面
- 確認が必須となる情報の種類(数値、固有名詞、日付、法令など)
- 出典を明示する必要がある文書の範囲
- 誤りを見つけたときの報告先と対応手順
禁止事項を並べるより、使ってよい範囲を具体的に示すほうが現場では守られます。何がだめかではなく、何をすればよいかを書いてください。
確認の責任者を明確にする
誰が最終的に内容を保証するのかが曖昧なまま利用を広げると、確認が誰の仕事でもない状態になります。文書の種類ごとに責任者を決めてください。
社外に出る文書については、AIを使ったかどうかにかかわらず、既存の承認フローを通す形にするのが確実です。新しい仕組みを作るより、既存の統制に乗せるほうが定着します。
誤りが見つかった事例は、社内で共有してください。どんな場面で何を間違えたかの記録が蓄積されると、確認すべき箇所の精度が上がります。
教育でリテラシーの水準を揃える
ハルシネーションという言葉は知っていても、どんな場面で起こりやすいかまで理解している人は多くありません。ここに差があると、確認の質もばらつきます。
実際に誤った出力を見せる形の研修が効果的です。自分が見抜けなかった経験をすると、以降の確認が丁寧になります。
組織全体のリテラシーを引き上げる進め方は、生成AI活用研修のサービス内容が参考になります。
| 安全にAIを使える体制づくりを支援します ルールの設計から研修、現場への定着、効果測定までを一気通貫でご支援しています。まずは現状の課題整理からご相談ください。 ▶ 相談予約はこちら |
今後の見通しと付き合い方
技術は改善を続けています。とはいえ、近い将来にハルシネーションが消えるという見通しは立っていません。
ここでは、これからの向き合い方を整理します。
モデルの進化で頻度は下がるが完全にはなくならない
新しいモデルほど事実誤認は減っています。推論能力の向上や、検索との連携によって、確度の高い回答が返る場面は増えました。
しかし、仕組みそのものが確率的に言葉を選ぶ構造である以上、ゼロにはなりません。頻度が下がるほど、かえって確認が甘くなるという逆方向のリスクも生まれます。
出典を示す機能が一般的になりつつある
検索結果を参照して回答する仕組みや、参照元を明示する機能が広がっています。根拠をたどれる状態は、確認の負荷を大きく下げます。
ツールを選ぶ際は、出典を提示できるかどうかを条件の1つに入れてください。特に社外向けの用途では、この有無が運用の可否を分けます。
起こる前提で設計することが結論になる
対策を突き詰めても、最後に残るのは人が確認するという工程です。これは技術の未熟さではなく、責任の所在の問題です。
AIは判断の材料を速く用意する道具であり、内容の正しさを保証する道具ではありません。この線引きを組織で共有できていれば、過度に恐れる必要はありません。
まとめ|完全には防げない前提で、確認工程を業務に組み込む
ハルシネーションは、生成AIが事実でない内容をもっともらしく出力する現象です。次に来る言葉を予測するという仕組みに由来しており、公的資料でも完全には抑制できないと明記されています。
原因は、仕組みそのもの、学習データの範囲と時点、データに含まれる誤り、曖昧な指示、わからないと答えにくい設計の5つです。このうち指示の書き方は、現場ですぐ改善できる要素になります。
対策は、範囲と前提の明示、根拠と出典の提示、RAGによる社内データの参照、検索との突き合わせ、確認工程の組み込み、使う業務の選定という6つです。出力前と出力後の両面から手を打ってください。
そして、確認する箇所を数値、固有名詞、日付、法令の4つに絞ること。全文を検証しようとせず、重大な誤りだけを確実に止める運用が、現実的で続く形になります。
他社がどのようにリスク管理と活用を両立させたのかは、ネクストスケールの導入事例でご覧いただけます。
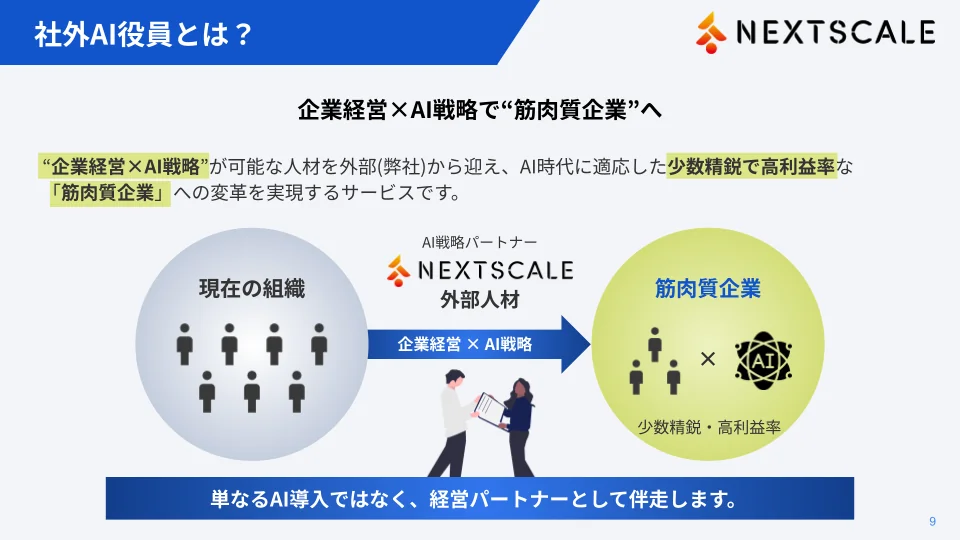
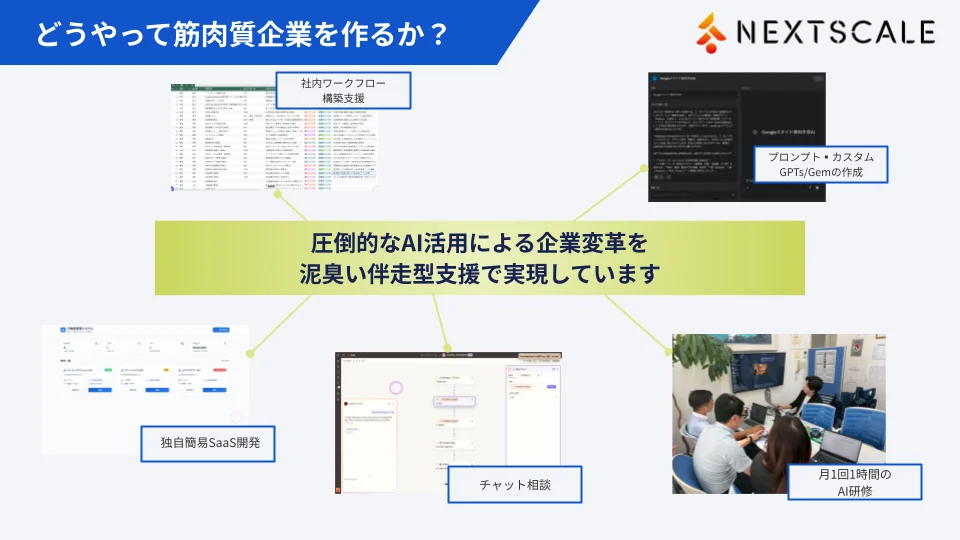
AIコンサル・AX伴走支援サービスご紹介資料
この資料でこんなことがわかります!
- 社外AI役員とは
- 支援内容
- 導入の進め方
- 導入実績・効果
\3ステップで簡単入力/
| 安全なAI活用の進め方を無料でご提案します 貴社の業務を伺い、リスクを抑えながらどこから着手すべきかを無料でご提案します。オンライン30分で完結し、助成金活用のご相談も歓迎しています。 ▶ 相談予約はこちら |
この記事の監修者
株式会社ネクストスケール 代表取締役

関連記事
-
 AI受託開発とは?依頼できること・費用相場・開発会社の選び方と成功のポイントを解説
-
AI開発のPoCとは?進め方・費用・成功のポイントと「PoC止まり」を防ぐ方法を解説
-
バイブコーディングとは?やり方・おすすめツールとメリット・注意点を解説【2026年最新】
-
AIアプリおすすめ15選|無料で使える目的別の選び方と業務利用の注意点【2026年最新】
-
AIを活用したアプリ開発とは?手順・費用・おすすめツールまで解説
-
AIアプリ開発の費用相場は?内訳・種類別の目安と費用を抑える方法
-
AIアプリ開発をノーコードで実現!おすすめツールと進め方を解説
-
AIプロダクト開発の進め方とは?手順・開発手法・成功のポイントを解説