Power Automateのエラー処理 実行条件の構成とTry-Catch・再試行の設定を解説
 2026年9月14日
 著者:NEXT SCALE編集部
監修者:石丸真平
作ったフローが動かなくなり、気づいたのは数日後だった。1件のデータでエラーが出ただけなのに、残り全件の処理まで止まっていた。Power Automateを業務に組み込み始めると、ほぼ必ずこうした場面に出くわします。
Power Automateは、既定ではアクションが1つ失敗した時点で以降をすべてスキップし、フローを失敗として終了します。この動作を前提にしたまま運用すると、止まったことに誰も気づかないまま業務が滞ります。逆に言えば、エラー処理を組み込んでおけば、失敗しても通知が飛び、必要な後始末まで自動で走らせられます。
本記事では、エラー処理の基本的な考え方から、クラウドフローでの実行条件の構成とスコープによるTry-Catch、再試行ポリシー、デスクトップフローでの例外処理、そして通知とログの設計までを順番に整理します。
| 確認したいポイント | 結論 | 詳細 |
| エラー処理をしないとどうなる? | 以降がスキップされ失敗で終了 | アクションが失敗した時点で後続がすべてスキップされ、その時点でフローが失敗として終わります。 |
| 失敗時に別の処理を動かすには? | 実行条件の構成を使う | アクションの三点リーダーから実行条件を開き、「に失敗しました」にチェックを入れて分岐させます。 |
| まとめて例外処理したい | スコープでTry-Catch-Finally | 3つのスコープを並べ、Catchは失敗時とタイムアウト時、Finallyは常に実行する設定にします。 |
| 一時的なエラーへの備えは? | 再試行ポリシーを設定する | 公式では指数間隔が推奨されており、初期間隔と最大再試行回数をアクション設定で指定します。 |
この記事でわかること
- エラー処理を入れていないフローが、失敗時にどう振る舞うのか
- 実行条件の構成で、失敗時に別の処理へ分岐させる設定手順
- スコープを使ってTry-Catch-Finallyの構造を再現する方法とその制限
- 一時的な障害に備える再試行ポリシーと、終了アクションの使いどころ
- Power Automate for desktopでの「エラー発生時」「ブロックエラー発生時」の使い方
| ▼ 業務自動化をどこまで安定して運用できるか整理したい方へ Power Automateや生成AIを使った業務自動化の進め方、支援内容、導入までの流れをまとめた資料をご用意しています。 検討の初期段階でも構いませんので、まずは全体像の把握にご活用ください。 > 資料請求はこちら |
 こんな方におすすめ

Power Automateのエラー処理の基本
設定方法に入る前に、前提を整理します。既定の動作を知らないまま対策を打っても、狙った挙動にはなりません。まずは何が起きるのか、どこから手をつけるのかを押さえます。
何も設定しないとどうなるか
アクションが失敗すると、それ以降のアクションはすべてスキップされ、その時点でフローが失敗として終了します。途中まで進んでいた処理は巻き戻らないため、中途半端な状態のデータが残ることもあります。
たとえば「データを登録してから通知を送る」というフローで登録に失敗すれば、通知は飛びません。逆に「通知を送ってから登録する」順序なら、通知だけが送られて登録されていない、という食い違いが起きます。
つまり、エラー処理を入れないということは、失敗したときの挙動を設計していないということです。業務で使うフローであれば、失敗時に何が起きてほしいかを必ず決めておく必要があります。
クラウドフローとデスクトップフローで方法が違う
Power Automateには2種類のフローがあり、エラー処理の仕組みもそれぞれ別です。クラウドフローでは実行条件の構成とスコープ、デスクトップフローではアクションごとの「エラー発生時」設定とブロックエラーを使います。
記事や情報を探すときは、どちらのフローの話かを必ず確認してください。用語も操作画面も異なるため、取り違えると設定にたどり着けません。本記事では両方を扱います。
なお、トリガー自体が動いていない場合は、フローの中身ではなく接続やライセンス、フローの有効・無効の状態を疑ってください。エラー処理を組み込んでも、そもそも起動していなければ通知は飛びません。
まず実行履歴でエラーを特定する
対策を打つ前に、何が起きているかを確認します。クラウドフローなら実行履歴、デスクトップフローなら実行ログを開けば、どのアクションでどんなエラーが出たかが残っています。
失敗したアクションを開くと、入力値と出力されたエラーメッセージを確認できます。ここを見ずに推測で直そうとすると、遠回りになります。
エラーメッセージが英語で返ってくることも多いため、そのまま検索するのが早い解決につながります。特に権限やスロットリングに関するエラーは、メッセージに原因がほぼ書かれています。
一時的なエラーと恒久的なエラーを分ける
エラー処理を設計するうえで重要なのが、時間をおけば解決するものと、直さない限り解決しないものを区別することです。
ネットワークの瞬断、サービス側の一時的な過負荷、短時間に呼び出しすぎたことによる制限は前者です。これらは再試行で解決する可能性が高く、自動的にリトライさせる価値があります。
一方、権限がない、参照先のファイルが存在しない、列名が変わっているといった原因は、何度繰り返しても同じ結果です。こちらは通知して人が対応する設計にします。
クラウドフロー:実行条件の構成
クラウドフローのエラー処理で最も基本になるのが、実行条件の構成です。アクション単位で、前のアクションがどうなったときに実行するかを指定できます。
実行後設定とは何か
実行条件の構成は、公式には実行後設定と呼ばれる機能です。アクションが失敗した場合、タイムアウトした場合、スキップされた場合、成功した場合のそれぞれについて、次のステップを実行するかどうかを指定できます。
既定では「成功しました」だけにチェックが入っています。そのため、前のアクションが失敗すると後続は動きません。このチェックを付け替えることで、エラー時の代替パスを作れるというのが基本の仕組みです。
公式のガイダンスでも、この設定を使って失敗時に通知を送ったり、エラーの詳細をログに記録したりする方法が示されています(出典:Microsoft Learn「堅牢なエラー処理を採用する」)。
設定の手順
操作は簡単です。対象アクションの右上にある三点リーダーから「実行条件の構成」を選び、表示されたチェックボックスを設定するだけです。
エラー時に動かしたいアクションでは、「成功しました」のチェックを外し、「失敗しました」にチェックを入れます。必要に応じて「タイムアウトしました」も追加します。設定すると、デザイナー上で前後のアクションをつなぐ矢印の表示が変わり、通常とは違う経路であることが視覚的に分かります。
よくある使い方が、一致する行が見つからずにエラーになるケースへの対処です。検索系のアクションは、該当がないと失敗として扱われることがあります。この場合、後続で「失敗しました」を条件にすれば、該当なしのときの処理へ分岐させられます。
ここで注意したいのは、後続に実行条件を設定しても、フロー全体のステータスは失敗のまま残るという点です。実行履歴を成功に見せたい場合は、別途終了アクションでステータスを指定する必要があります。
失敗時に通知を送る
最小限のエラー処理としておすすめなのが、フローの最後に通知用のアクションを置き、実行条件を「失敗しました」に設定する構成です。これだけで、止まったことに気づけるようになります。
通知には、フロー名、発生時刻、対象データの識別子を含めておくと、受け取った側がすぐ動けます。エラーメッセージそのものも入れておくと、調査の初動が早くなります。
スキップとタイムアウトの扱い
4つの条件のうち、見落とされやすいのがスキップとタイムアウトです。スキップは、その前のアクションが実行条件を満たさず飛ばされた状態を指します。
分岐を複数作ると、どの経路を通ってもスキップされるアクションが出てきます。最後に必ず実行したい処理がある場合は、4つすべてにチェックを入れておく必要があります。
| ▼ 止まらない自動化の作り方をご相談いただけます エラー処理の設計、通知の設計、運用体制まで含めて、現状に合わせた進め方をご提案します。 導入前の検討段階でも構いません。 > 相談予約はこちら |
 サービス資料をダウンロードする
クラウドフロー:スコープでTry-Catch-Finallyを作る
アクションが増えてくると、1つずつ実行条件を設定するのは現実的ではありません。スコープを使えば、複数のアクションをまとめて扱い、プログラミング言語のTry-Catch-Finallyに近い構造を再現できます。
スコープとは
スコープは、複数のアクションをひとまとめにするコントロールです。スコープ全体の実行結果は、中のいずれかが失敗すればエラーになります。この性質を使って、まとまった処理の成否を1つの単位として扱えます。
デザイナー上でも折りたためるため、フローが長くなったときの見通しがよくなるという副次的な利点もあります。
ただし、スコープを深く入れ子にしすぎると、かえって読みにくくなります。工程のまとまりごとに1階層、という程度に抑えておくほうが保守しやすくなります。
3つのスコープを並べる
組み方はシンプルです。Try、Catch、Finallyと名前を付けた3つのスコープを順に並べます。Tryにはメインの処理、Catchにはエラー時の処理、Finallyには成否にかかわらず行いたい処理を入れます。
Catchスコープの実行条件は、「成功しました」のチェックを外し、「失敗しました」と「タイムアウトしました」にチェックを入れます。Finallyスコープは、4つすべてにチェックを入れて常に実行されるようにします。
この設定により、Try内でエラーが起きるとCatchへ処理が流れ、その後Finallyが実行されるという流れができます。Catchではエラー内容の記録、Finallyでは完了通知やクリーンアップを行うのが典型的な使い分けです。
result関数でエラー内容を取得する
Catchの中で「何が失敗したのか」を知るには、result関数を使います。スコープ名を引数に渡すと、そのスコープ内のアクションの実行結果が配列で返ってきます。
公式の例では、この応答を「配列のフィルター処理」アクションで絞り込み、失敗したアクションだけを取り出す方法が紹介されています。取得した内容には、アクション名やエラーメッセージが含まれるため、そのまま通知やログに流せます。
ログに残す場合は、フロー名や実行日時もあわせて記録しておきます。workflow関数を使えば、実行中のフローのIDや名前を取得でき、実行履歴への直接リンクを組み立てることもできます。
result関数の制限を知っておく
便利な関数ですが、制限があります。result関数で取得できるのは、対象スコープ内の最上位のアクションの情報だけです。Apply to eachの中で起きたエラーの詳細までは取得できません。
ループ内の個別のエラーを捕まえたい場合は、ループの内側にもTry-Catchを置く構成にします。Catchで失敗した件の情報を変数に追記していき、ループが終わった後にまとめて通知する、という作りが実用的です。
この構成には副次的な効果もあります。ループ内でエラーを吸収するため、1件の失敗で残りの処理が止まらなくなります。大量データを扱うフローでは、この設計が特に効いてきます。
| ▼ 既存フローの見直しもご相談いただけます 「動いてはいるが不安定」「エラーのたびに人が対応している」といった状態の改善も含めて、実務目線でご相談を承っています。 > 相談予約はこちら |
再試行ポリシーと終了アクション
分岐の設計に加えて、一時的な障害から自動で回復する仕組みと、あえて止める仕組みも押さえておきます。どちらもアクションの設定から構成できます。
再試行ポリシーの考え方
再試行ポリシーは、ネットワークやサービス側の一時的な問題による失敗から回復するための機能です。固定間隔と指数間隔のどちらかを選べます。
公式のガイダンスでは、指数関数的な再試行ポリシーが推奨されています。再試行の間隔を徐々に広げることで、頻繁な再試行でシステムに負荷をかけるのを避けつつ、問題が解消するまでの時間を確保できるためです。
公式に示されている例では、1回目は1分後、2回目は2分後、3回目は4分後というように間隔が広がっていきます。短時間に呼び出しすぎて制限にかかった場合などは、この仕組みだけで解決することがあります。
なお、すべてのアクションで再試行ポリシーを設定できるわけではありません。設定画面に項目が表示されないアクションもあるため、対象を確認したうえで設計してください。
設定する項目
設定は、対象アクションの設定画面から行います。指定するのは、最初の再試行までの初期間隔と、最大の再試行回数です。既定でも自動的な再試行は行われますが、必要に応じて明示的に調整します。
注意したいのは、再試行が有効な間はフローが待機状態になることです。回数と間隔を大きくしすぎると、1回の実行時間が長くなります。タイムアウトや後続処理への影響を見ながら、現実的な値に収めてください。
また、何度繰り返しても解決しないエラーに再試行を設定しても意味がありません。権限や設定の誤りが原因のアクションでは、再試行より通知を優先します。
終了アクションで意図的に止める
重大なエラーが起きたときに、それ以上処理を進めたくない場面があります。この場合は終了アクションを使います。ステータスを指定してフローを停止でき、それ以降のアクションは実行されません。
終了アクションでは、ステータスに加えてメッセージも指定できます。ここに理由を書いておけば、実行履歴を見たときに何が起きたのかが一目で分かります。
使いどころは、データの整合性が崩れる危険があるときです。前提条件を満たしていないまま後続の更新処理を走らせるより、明示的に止めて人が確認するほうが安全な場面は少なくありません。
デスクトップフローのエラー処理
Power Automate for desktopでは、仕組みが大きく異なります。アクション単位の設定と、まとまった範囲に適用するブロックエラーの2段構えで考えます。
アクションごとの「エラー発生時」設定
各アクションの設定画面には、エラー発生時という項目があります。ここで、そのアクションが失敗したときの挙動を指定できます。
既定はエラーをスローする設定で、失敗するとフローが停止します。これを「フロー実行を続行する」に変更すると、次のアクションへ進む、アクションを繰り返す、ラベルへ移動するといった選択肢から挙動を選べます。
あわせて、変数の設定やサブフローの実行も指定できます。エラー時に専用のサブフローを呼び出す構成にしておけば、複数箇所で同じ後始末を使い回せます。
再試行の設定
同じ設定画面で、再試行のオン・オフと、回数・間隔も指定できます。既定ではオフで、エラーが起きても再試行しません。
画面の表示待ちやファイルのロックなど、少し待てば解消する可能性があるアクションでは有効です。逆に、要素が見つからないといった原因では、繰り返しても結果は変わりません。
「アクションを繰り返す」を選ぶ場合は、回数の上限に注意してください。解消しないエラーに対して繰り返し続ける設定にすると、無限ループになり手動で止めるまで終わりません。
「ブロックエラー発生時」でまとめて処理する
複数のアクションに同じエラー処理を適用したい場合は、「ブロックエラー発生時」アクションを使います。囲んだ範囲内のすべてのアクションに、設定した例外処理が適用されます。
クラウドフローのTryスコープに近い考え方で、ブロック内でエラーが起きたときの動作をまとめて定義できます。ブロックの先頭や末尾へジャンプさせることもでき、リトライ処理を組む用途にも使えます。
注意点として、ブロック内では複数の種類のエラーが起こり得るため、処理は汎用的なものにせざるを得ません。エラーメッセージを取得して記録する、通知を出す、といった内容にとどめるのが現実的です。
エラー内容を取得して記録する
エラー処理のサブフローの中では、「最後のエラーを取得」アクションでエラー情報を取得できます。これをログファイルやメール本文に渡せば、何が起きたのかを残せます。
なお、UI要素が見つからないことによるエラーについては、実行時に最も可能性の高い要素を特定して処理を続行する機能も提供されています。詳細はMicrosoft Learn「デスクトップ フローでエラーを処理する」を確認してください。
| ▼ つまずいたところだけでも相談できます 「エラーの原因が分からない」「作ったフローが頻繁に止まる」といった個別の課題も含めて、実務目線でご相談を承っています。 > 相談予約はこちら |
通知とログの設計
エラーを捕まえられるようになったら、次はそれをどう届け、どう残すかです。ここの設計が甘いと、せっかくのエラー処理が機能しません。
既定のアラートだけでは足りない場面
Power Automateには、接続の切断や調整の問題といった重大な障害について、フローの所有者へメールアラートを送る仕組みが標準で備わっています。まずはこの通知先が、現在も確認されているアドレスかを点検してください。
ただし、標準のアラートはフロー単位の話です。「1件だけ失敗した」「件数が0だった」といった業務上の異常は拾えません。こうした条件は、自分で判定して通知する必要があります。
通知先も設計対象です。個人のメールアドレスではなく、チームの共有メールやチャットのチャネルに送る構成にしておけば、担当者の不在時にも気づける状態を保てます。
ログをどこに残すか
エラーの詳細を残す先としては、SharePointリストやDataverseなどが使われます。実行日時、フロー名、対象データの識別子、エラーメッセージを1行として記録する形が基本です。
実行履歴への直接リンクを含めておくと、調査が格段に楽になります。workflow関数で取得した情報からURLを組み立てる方法が公式にも示されています。
成功したときの記録も残しておくと、「いつから動いていないのか」を追えるようになります。エラーが出ずに静かに止まっているケースは、この記録がないと発見が遅れます。
通知を出しすぎない
注意したいのが、通知やログを増やしすぎること自体がアンチパターンになるという点です。公式のガイダンスでも、カスタムログが過剰になるとアクション数が増え、パフォーマンスに悪影響を与えると注意喚起されています。
頻繁にアラートが飛ぶ状態になると、受け取る側が見なくなります。本当に人の対応が必要なものだけを通知し、それ以外はログに残すだけにする、という切り分けが必要です。
Application Insightsという選択肢
カスタムログを自作する代わりに、Application Insightsを使ってクラウドフローのエラーを監視する方法も用意されています。フロー側にログ用のアクションを追加せずに済むため、パフォーマンスへの影響を抑えられます。
フローの本数が増え、個別に通知を組むのが現実的でなくなってきた段階で検討する価値があります。設定には環境側の準備が必要になるため、情報システム部門との連携が前提です。
エラーに強いフローを設計する
エラー処理を後から足すより、最初から失敗する前提で設計するほうが結果的に楽になります。押さえておきたい考え方を整理します。
2回動いても壊れない作りにする
最も重要なのが、同じ処理が2回走っても結果が変わらない設計です。エラー後に手動で再実行する場面は必ず訪れます。そのときに二重登録が起きる作りでは、復旧そのものがリスクになります。
具体的には、追記の前に同じキーの行が存在しないかを確認する、処理済みのフラグを立てる、といった工夫です。この設計にしておけば、障害時に「とりあえずもう一度動かす」という対応が安全に取れます。
1件の失敗で全部を止めない
複数件をループで処理するフローでは、1件のエラーで残り全件が止まる構成は避けたいところです。前述のとおり、ループ内にTry-Catchを置いて個別に吸収します。
失敗した件は変数に記録しておき、処理の最後にまとめて報告します。成功分は反映され、失敗分だけを人が対応すればよい状態になるため、業務への影響が最小限で済みます。
あわせて、どこまでが自動復旧の対象で、どこからが人の対応かを線引きしておきます。この境界が曖昧だと、通知を受け取った人が何をすべきか判断できません。
エラー処理そのものをテストする
見落とされがちですが、エラー処理が正しく動くかを確認するテストも必要です。正常系だけを試して本番に出すと、いざエラーが起きたときに通知が飛ばない、ということが起こります。
存在しないファイルを指定する、権限のないリストを参照する、といった方法で意図的にエラーを起こし、Catchが動くこと、通知が届くことを確認してください。
作った人に依存しない状態にする
自動化で最も多い失敗は、作成者の異動とともに誰も触れなくなることです。部署内に最低2人は中身が分かる人を置き、エラー時の連絡先と対処手順をメモに残すことが確実な対策になります。
どの業務のどの工程を代替しているか、止まったときに手作業でどう埋め合わせるか。この2点が書かれているだけで、現場の混乱度合いが大きく変わります。業務全体の整理の仕方は業務効率化アイデア55選の記事でもまとめています。
あわせて、社内で作れる人を増やす取り組みも並行して進めてください。ツールを導入するだけでは、使いこなせる状態にはなりません。育て方の考え方はAI研修の目的と選び方をまとめた記事も参考になります。
まとめ
Power Automateは、既定ではアクションが1つ失敗した時点で以降をスキップし、フローを失敗として終了します。業務で使うなら、失敗したときに何が起きてほしいかを設計しておく必要があります。
クラウドフローでの基本は実行条件の構成です。「失敗しました」にチェックを入れることで、エラー時の代替パスを作れます。複数のアクションをまとめて扱うなら、スコープを3つ並べてTry-Catch-Finallyの構造を再現します。
一時的な障害には再試行ポリシーで備え、指数間隔を選びます。何度繰り返しても解決しないエラーには再試行ではなく通知を、データの整合性が危うい場面では終了アクションを使います。デスクトップフローでは、アクションごとの「エラー発生時」とブロックエラー発生時を組み合わせます。
そして、通知を出しすぎないこと、2回動いても壊れない作りにすること、エラー処理そのものをテストすること。この3点を設計に含めておけば、フローは止まっても業務は止まらない状態をつくれます。
AIコンサル・AX伴走支援サービスご紹介資料
この資料でこんなことがわかります!
- 社外AI役員とは
- 支援内容
- 導入の進め方
- 導入実績・効果
\3ステップで簡単入力/
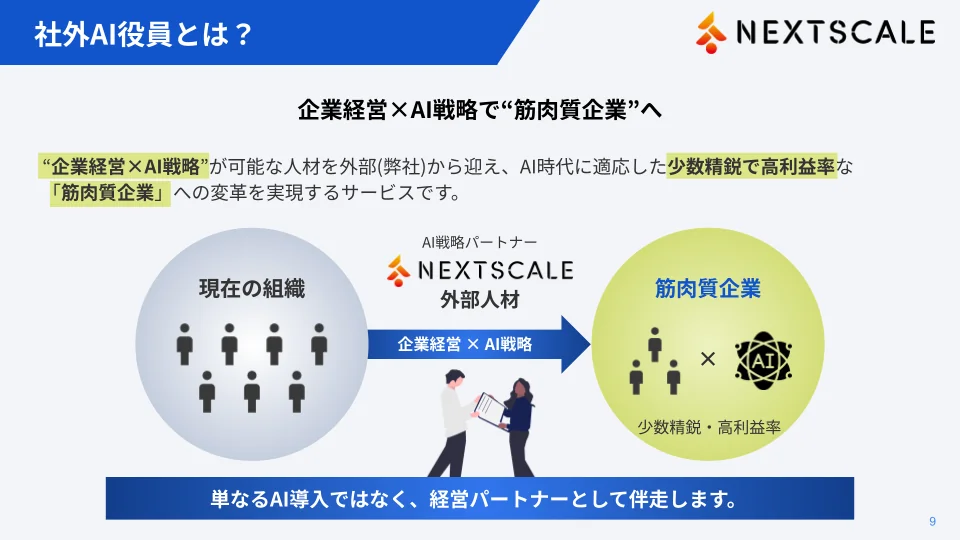
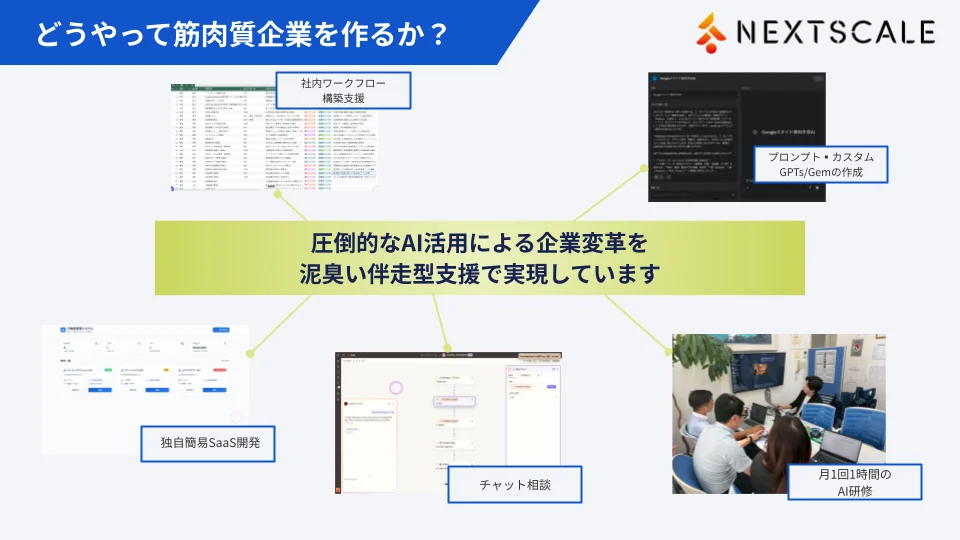
| ▼ 業務自動化を、止まらない形で運用しませんか 株式会社ネクストスケールでは、業務の棚卸しから自動化の設計、エラー処理を含む運用設計と社内への定着支援までを一貫してご支援しています。まずはお気軽にご相談ください。 > 相談予約はこちら |
この記事の監修者
株式会社ネクストスケール 代表取締役

関連記事
-
 AI在庫管理とは?仕組み・メリット・活用事例と導入のポイントを解説
-
業務効率化ツールとは?目的別の選び方・おすすめカテゴリ・導入のコツを徹底解説
-
業務効率化ソリューションとは?種類・選び方・導入手順と2026年の注目トレンドを解説
-
業務効率化の相談先はどこ?専門家の選び方・無料窓口・依頼時のポイントを解説
-
RPAで業務効率化を実現するには?導入メリット・活用事例・ツール選びと注意点を解説
-
ワークフローで業務効率化を実現するには?導入メリット・ツール選び・成功事例を解説
-
クラウドで業務効率化を実現するには?メリット・ツール選び・導入手順と注意点
-
経理の業務効率化とは?課題・具体的な方法・ツール・AI活用と成功事例を解説