テーブル設計のアンチパターン10選 症状と対策・レビューで確認すべき点
 2026年9月14日
 著者:NEXT SCALE編集部
監修者:石丸真平
「テーブルに列を1つ追加するだけのはずが、影響範囲の調査に数日かかった」「同じ顧客が別のテーブルにも登録されていて、どちらが正しいか分からない」。設計の誤りは、こうした形で後から現れます。
テーブル設計のアンチパターンとは、一見動いてしまうが、後で必ず困ることになる設計の型です。多くは正規化の不徹底、あるいは汎用性を求めすぎたことに起因します。
問題は、動いてしまうから気づかないという点にあります。データが少ないうちは何も起きません。件数が増え、要件が追加され、担当者が変わった段階で初めて表面化します。
この記事では、実務で頻出する10のアンチパターンを、症状と対策をセットで整理します。あわせて、例外的に許容できる条件と、設計レビューで確認すべき点も扱います。
| 確認したいポイント | 結論 | 詳細 |
| アンチパターンとは? | 後で必ず困る設計の型 | 動いてしまうため気づきにくく、データが増えてから問題が表面化します。 |
| 最も多いのは? | 1列に複数の値を詰め込む設計 | カンマ区切りでの格納や、列を横に並べる設計が代表的なものです。 |
| なぜ避けるべき? | 後から直すコストが極端に高い | データが入った後の構造変更は、移行と全処理の修正を伴います。 |
| 例外はある? | 根拠があれば許容できる | 性能のための非正規化などは、理由を記録したうえで採用します。 |
この記事でわかること
- 実務で頻出する10のアンチパターンと、それぞれの症状・対策
- 1列に複数値を詰め込む設計が招く具体的な問題
- 汎用属性テーブルや外部キー不使用が後で何を引き起こすか
- 例外的にアンチパターンを許容できる条件と、その記録の残し方
- 設計レビューで確認すべき点と、既存システムで見つけた場合の対処
| システム開発とAI活用の進め方をまとめた資料を無料で配布しています 要件整理の進め方、開発や試験の依頼範囲の決め方、費用と期間の目安を1冊にまとめました。 社内での検討材料としてご活用いただけます。 ▶ 資料請求はこちら ※オンライン完結/しつこい営業は一切いたしません |
 こんな方におすすめ

なぜアンチパターンを知る必要があるのか
設計の誤りは、実装の誤りとは性質が違います。後から直すコストが桁違いに大きくなります。
設計の誤りは後から直せない
プログラムの誤りは、該当箇所を修正すれば済みます。テーブル構造の誤りは、データの移行とそれを参照するすべての処理の修正を伴います。
稼働後であれば、さらにサービスの停止も必要です。修正のコストは、データ量と経過時間に比例して増えていきます。
IPA(情報処理推進機構)が公開する共通フレーム2013は、システムのライフサイクルを通じて必要な作業項目と役割を包括的に規定した枠組みです。設計工程の成果物を確定させてから次へ進むという考え方は、この種のリスクを踏まえたものです。
動いてしまうから気づかない
アンチパターンの厄介さはここにあります。構文上は正しく、テストも通り、データも保存されます。単体テストでも結合テストでも検出されません。
問題が現れるのは、データが増えたとき、要件が追加されたとき、担当者が変わったときです。いずれも設計から時間が経った後になります。
「1年前に作った人は退職していて、なぜこの構造なのか誰も知らない」という状態が、最も対処が困難です。
レビューで防ぐしかない
テストでは検出できないため、設計レビューが唯一の防御線になります。
レビューを機能させるには、見るべき観点が共有されている必要があります。アンチパターンを知っておくこと自体が、レビューの観点になります。
発注側にとっても意味があります。技術的な詳細は分からなくても、「この設計は後で困りませんか」と問えるだけで、見直しのきっかけになります。要件の書き方については要件定義の例|システム種類別の要件例と、機能要件・非機能要件の書き換え集も参考になります。
1つの列に詰め込むアンチパターン
最も頻出する類型です。1つの列に複数の意味や値を持たせてしまう設計です。
① カンマ区切りで複数の値を格納する
症状:1つの列に「1,4,7」「東京,大阪,福岡」のように、区切り文字でつないだ複数の値を入れる。
【アンチパターン】
products テーブル
id | name | tag_ids
1 | テスト商品A | 3,7,12
何が起きるか:特定のタグを含む商品を検索するSQLが書けません。文字列の部分一致で代用すると、「1」を探して「12」や「21」も拾ってしまいます。集計も、件数のカウントもできません。
さらに、参照整合性が保証できません。存在しないタグIDが入っていても、データベースは検出できません。区切り文字を含む値が現れた場合も破綻します。列の長さ制限にも引っかかります。
対策:中間テーブルを作り、多対多の関係として表現します。1行1件にすれば、検索、集計、整合性のすべてが標準のSQLで扱えます。
【対策】
product_tags テーブル(中間テーブル)
product_id | tag_id
1 | 3
1 | 7
1 | 12
② 列を横に並べて複数の値を持つ
症状:tag1、tag2、tag3のように、同じ意味の列を番号付きで並べる。列持ちテーブルとも呼ばれます。
何が起きるか:4つ目が必要になった時点で、テーブルの変更が必要です。そして、そのテーブルを参照するすべての処理に影響します。
検索も煩雑になります。「タグ7を持つ商品」を探すには、tag1からtag3のすべてを条件に並べる必要があります。列が増えるたびに、SQLの修正が発生します。
対策:①と同じく、行に展開します。1件を1行として別テーブルに持たせれば、件数の増減に構造の変更は不要になります。
③ 「その他」「備考」に何でも入れる
症状:用途を限定しない自由記述の列を作り、様々な種類の情報を入れる。
何が起きるか:取得したデータが何を表すのかが判別できません。アプリケーション側で文字列を解析して判断するという処理が生まれます。
検索の条件にも使えず、集計もできません。時間が経つと、書き方のルールが担当者ごとにばらつき、解析すること自体が不可能になります。
対策:入ってくる値の種類を洗い出し、それぞれに専用の列を定義します。運用上どうしても自由記述が必要なら、その列は検索や集計に使わないという前提を明記します。
 サービス資料をダウンロードする
汎用性を求めすぎるアンチパターン
「将来どんな項目が増えても対応できるように」という善意から生まれる類型です。結果として、扱いにくい構造になります。
④ 何でも入る汎用属性テーブル
症状:項目名と値を行として持たせ、どんな属性でも格納できるテーブルを作る。EAVと呼ばれる構造です。
【アンチパターン】
attributes テーブル
entity_id | attr_name | attr_value
1 | 氏名 | テスト太郎
1 | 生年月日 | 1985-04-01
1 | 与信限度額 | 3000000
何が起きるか:まず、データ型を指定できません。すべてを文字列で持つため、日付として比較できず、金額として集計できません。不正な値の混入も防げません。
必須項目の制約もかけられません。1件の情報を取り出すには、行数分の結合が必要になり、SQLが極端に複雑化します。性能も大きく劣化します。
対策:属性は列として定義します。本当に可変な項目が必要な場合は、その部分だけを分離し、それ以外は通常のテーブルとして設計します。全体をEAVにするという判断は避けます。
⑤ 複数の親を1つの列で参照する
症状:「対象種別」と「対象ID」という2列を持たせ、種別によって参照先のテーブルを切り替える設計です。
【アンチパターン】
comments テーブル
id | target_type | target_id | body
1 | product | 100 | コメント本文
2 | article | 100 | コメント本文
何が起きるか:外部キー制約を設定できません。target_idが100であっても、それがproductsの100なのかarticlesの100なのかは、データベースには判断できません。
結果として、参照先が存在しないデータが残ります。親を削除しても、子のコメントは孤立したまま残り続けます。データの整合性を定期的なチェックで担保するしかなくなります。
対策:参照先ごとにテーブルを分ける(product_comments、article_comments)か、共通の親テーブルを設けてそこを参照させます。どちらも外部キー制約が設定できる構造です。
⑥ 単一の参照マスタに全コードを集約する
症状:区分コードや選択肢の値を、種別で区別しながら1つのマスタテーブルにまとめる設計です。汎用マスタ、コードマスタと呼ばれます。
何が起きるか:④と同様の問題が発生します。種別ごとに異なる属性を持てず、外部キー制約も設定しにくくなります。
また、テーブルが1つに集中するため、参照の頻度が極端に高くなります。性能のボトルネックになりやすい構造です。
対策:区分ごとにマスタテーブルを分けます。テーブル数は増えますが、それぞれに適切な列と制約を設定でき、意味も明確になります。
| 設計の妥当性の確認からご相談いただけます 型は分かっても、自社の設計が妥当かの判断は別の問題です。 業務の構造の整理からご一緒する30分の無料相談をご用意しています。 ▶ 相談予約はこちら ※オンライン完結/秘密厳守/助成金活用のご相談も歓迎 |
キーと制約のアンチパターン
データの正しさをデータベース側で保証しないという類型です。
⑦ すべてのテーブルに意味のないIDを置く
症状:元のモデルに主キーになりうる意味のある値が存在する場合にも、すべてのテーブルの主キーに連番のid列を用いる設計です。
何が起きるか:中間テーブルで特に問題になります。商品とタグの中間テーブルに連番のidを付け、product_idとtag_idの組み合わせに一意制約を付けないと、同じ組み合わせが重複して登録されます。
また、意味のある一意キーが存在するのに使われないため、そのキーでの一意性が保証されません。社員番号や商品コードが重複して登録できてしまう状態になります。
対策:連番のidを使うこと自体は、多くのフレームワークの規約でもあり問題ではありません。重要なのは、意味のある一意キーにユニーク制約を併せて設定することです。中間テーブルでは、組み合わせを複合主キーにするという選択もあります。
⑧ 外部キー制約を貼らない
症状:テーブル間に参照関係があるにもかかわらず、外部キー制約を設定しない。「性能が落ちるから」「アプリ側でチェックするから」という理由が挙げられます。
何が起きるか:参照先が存在しないデータが必ず発生します。アプリケーション側のチェックには漏れが生じ、データ移行や直接のSQL実行では検証されません。
結果として、整合性を確認するスクリプトを定期的に実行するという運用が生まれます。外部キー制約を使えば、この運用そのものが不要になります。
対策:参照整合性、一意性、データ型はデータベース側で保証するという原則に立ちます。外部キー制約とユニーク制約を適切に設定し、そもそも設定できる構造で設計します。
⑨ 同じ意味のマスタが複数存在する
症状:顧客マスタが営業部門用と経理部門用に別々に存在する。あるいは、旧システムからの移行で2つのマスタが並存している。
何が起きるか:どちらが正しいのか判断できません。片方だけを更新する運用が生まれ、時間が経つほど乖離が広がります。
集計の結果も一致しません。「顧客数は何件か」という単純な問いに、部門ごとに違う答えが出るという状態になります。
対策:どちらを正とするかを決め、一方に統合します。業務上どうしても分けたい場合は、一方を正としてもう一方はそこから生成するという関係にします。両方で独立して更新する運用は避けます。
構造と型のアンチパターン
後から気づいても直しにくい類型です。特に型の選択は、データが入った後の変更が困難になります。
⑩ 年月や区分でテーブル・列を分割する
症状:orders_2024、orders_2025のように年ごとにテーブルを作る。あるいは sales_jan、sales_feb のように列を月で分ける。
何が起きるか:全期間を対象にした集計ができません。すべてのテーブルを結合するSQLを書く必要があり、しかも年が変わるたびにそのSQLを修正することになります。
新しいテーブルを作り忘れると、その期間のデータが登録できなくなります。制約の設定漏れも起こります。年をまたぐデータの移動では、主キーの重複が問題になることもあります。
対策:1つのテーブルに年月の列を持たせます。件数が問題になる場合は、データベースの分割機能(パーティショニング)を使います。論理的には1つのテーブルとして扱いながら、物理的に分割できます。
データとメタデータを混ぜない2つの原則
⑩の背景にある考え方です。2つの原則として整理できます。
- データにメタデータを混入させない:テーブル名や列名を値として格納しない
- メタデータにデータを混入させない:属性の値をもとにテーブルや列を作らない
④のEAVは1つ目に、⑩の年月分割は2つ目に該当します。この2つの原則で、複数のアンチパターンをまとめて判定できます。
金額に浮動小数点型を使う
症状:金額や数量にFLOATやDOUBLEといった浮動小数点型を使う。
何が起きるか:丸め誤差が発生します。0.1を10回足しても1.0にならないという現象が起こり、集計結果が1円ずれます。金額を扱う業務では許容されません。
しかも、発覚するのは集計を始めてからです。個々のデータを見ている限り気づきません。
対策:金額には固定小数点型(DECIMALやNUMERIC)を使います。あるいは、最小単位の整数で保持します。設計の段階で決めるべき事項であり、後からの変更は移行を伴います。
日付を文字列で持つ、NULLの扱いを決めない
症状:日付を「20260914」のような文字列で保持する。あるいは、NULLを許容するかどうかを列ごとに検討していない。
日付を文字列で持つと、期間の比較や日数の計算が正しく行えません。不正な日付が登録されても検出されません。日付型を使えば、データベースが妥当性を検証します。
NULLについては、「値が未入力」と「値が空」と「該当しない」を区別できているかが論点です。集計時にNULLがどう扱われるかを理解せずに設計すると、意図しない結果になります。
対策:型は意味に合ったものを選び、各列についてNULLを許容するかを明示的に決めます。許容する場合は、NULLが何を意味するのかを設計書に記載します。
例外的に許容できる場合
アンチパターンは絶対的な禁止事項ではありません。根拠があれば採用できる場面があります。
非正規化は悪ではない
性能を確保するために、あえて正規形を崩すという判断は正当です。集計値を持たせる、頻繁に結合するデータを1つのテーブルにまとめる。こうした設計は実務で広く行われています。
カンマ区切りでの格納についても、性能向上のために非正規化を行うケースでは、この形式を使ってもよいとされています。読み取り専用で、検索条件に使わないという前提であれば成立します。
問題は、理由なく採用することです。知らずにそうなっているのか、検討した結果として選んだのかで、まったく意味が変わります。
判断の条件
許容するかどうかは、次の3点で判断します。
- 代替案を検討したか:正しい設計にした場合の問題を実測したか
- 副作用を把握しているか:整合性の担保やSQLの複雑化をどう扱うか決めているか
- 将来の変更に対応できるか:要件が変わったときに戻せる構造か
1つ目が最も重要です。「結合が多いと遅そうだから」という推測での非正規化は、根拠になりません。実際に測って問題があると確認してから判断します。
決めたら記録に残す
採用した理由を設計書に残すことが必須です。これがないと、後から見た人が「単なる設計ミス」と判断します。
記録すべきは、なぜこの構造を選んだか、どういう副作用があるか、どういう条件になったら見直すかの3点です。
この記録が、将来の保守担当者への申し送りになります。理由が書かれていれば、不要に直そうとして問題を起こすことも防げます。
レビューで確認すべき点
設計書を受け取ったときに何を見るかを整理します。技術の詳細に踏み込まなくても確認できる観点があります。
チェックリスト
次の8点を順に確認すれば、主要なアンチパターンは検出できます。
□ 1つの列に複数の値が入る想定になっていないか
□ 番号付きで並んだ同じ意味の列がないか
□ 用途を限定しない自由記述の列が検索対象になっていないか
□ 項目名と値を行で持つ汎用テーブルがないか
□ 参照先が条件で変わる列がないか
□ 外部キー制約とユニーク制約が設定されているか
□ 年月や区分でテーブル・列が分かれていないか
□ 金額に浮動小数点型、日付に文字列型を使っていないか
すべて満たす必要はありません。該当した場合に「なぜこの設計なのか」を確認し、理由が説明できるかを見ます。説明できないなら、見直しの余地があります。
発注側として見るべき点
技術に詳しくない立場でも、業務の観点から確認できることがあります。
「この項目は将来増える可能性がありますか」「複数登録したい場合はどうなりますか」「同じ顧客が2件登録されることはありませんか」。業務上の疑問をそのまま問うだけで、設計の弱点が見つかることがあります。
将来の拡張について具体的に聞くのが効果的です。「支店が増えたら」「取扱商品が倍になったら」という問いに対して、構造の変更が必要という答えが返るなら、その部分は検討の余地があります。
既存システムで見つけた場合
稼働中のシステムでアンチパターンを見つけても、すぐに直せるとは限りません。現実的な対処を整理します。
まず、影響の大きさで優先順位を付けます。データの正しさに関わるもの(⑧⑨と、金額に浮動小数点型を使うケース)は優先度が高く、SQLが煩雑になるだけのものは後回しにできます。
次に、大規模な改修の機会に合わせて直すという判断があります。システムの刷新や大きな機能追加のタイミングであれば、移行のコストを他の作業と合わせられます。
直さないと決めた場合も、記録に残します。「この構造は既知の問題であり、当面は運用で回避する」と明記しておけば、後から見た人が混乱しません。委託時の役割分担についてはシステム開発の外注とは|メリット・デメリット、費用相場、外注先の種類と選び方でも整理しています。
設計を良くするための前提
個々のアンチパターンを避けるだけでは足りません。設計の質を上げる前提条件を整理します。
業務の理解が設計の質を決める
テーブル設計は、業務の構造を写し取る作業です。業務を理解していなければ、正しい構造にはなりません。
「1人の顧客が複数の配送先を持つか」「1つの注文に複数の支払方法が使えるか」。こうした業務のルールが、そのまま関係の設計になります。
技術的な知識より、業務部門への確認を丁寧に行うことのほうが設計の質に効きます。ここを推測で埋めると、後から構造の変更が必要になります。
性能要件を先に決めておく
非正規化の判断には、性能の目標値が必要です。これがないと、推測での判断になります。
IPAが公開する非機能要求グレードでは、可用性、性能・拡張性、運用・保守性など6つの大項目について、要求レベルを段階的に整理する枠組みが提供されています。想定データ量と応答時間を先に定めてから設計に入るのが正しい順序です。
データ量の見積りも必須です。3年後、5年後に何件になるのか。この数字によって、許容できる構造が変わります。
設計書を残す
テーブル定義書だけでは不十分です。なぜこの構造にしたのかが分かる記録が必要になります。
残すべきは、各テーブルの役割、主要な関係とその業務上の意味、採用した設計判断とその理由、既知の課題です。
外部に開発を委託している場合は、これらが納品物に含まれているかを確認します。テーブル定義書だけを受け取っても、後から自社で手を入れられません。
まとめ
テーブル設計のアンチパターンは、動いてしまうため気づきにくく、データが増えてから問題が表面化します。テストでは検出できないため、設計レビューが唯一の防御線になります。
頻出するのは、1列に複数値を詰め込む設計、汎用属性テーブル、複数の親を1列で参照する設計、外部キー制約を貼らない設計です。参照整合性と一意性はデータベース側で保証するという原則が軸になります。
背景にあるのは2つの原則です。データにメタデータを混入させない、メタデータにデータを混入させない。この視点で、複数のアンチパターンをまとめて判定できます。
アンチパターンは絶対的な禁止ではありません。性能のための非正規化など、根拠があれば採用できます。重要なのは、検討した結果として選び、理由を記録に残すことです。
まずは手元の設計書について、本記事のチェックリスト8項目を当ててみてください。該当する箇所が見つかったら、その理由を説明できるかを確認するところから始められます。
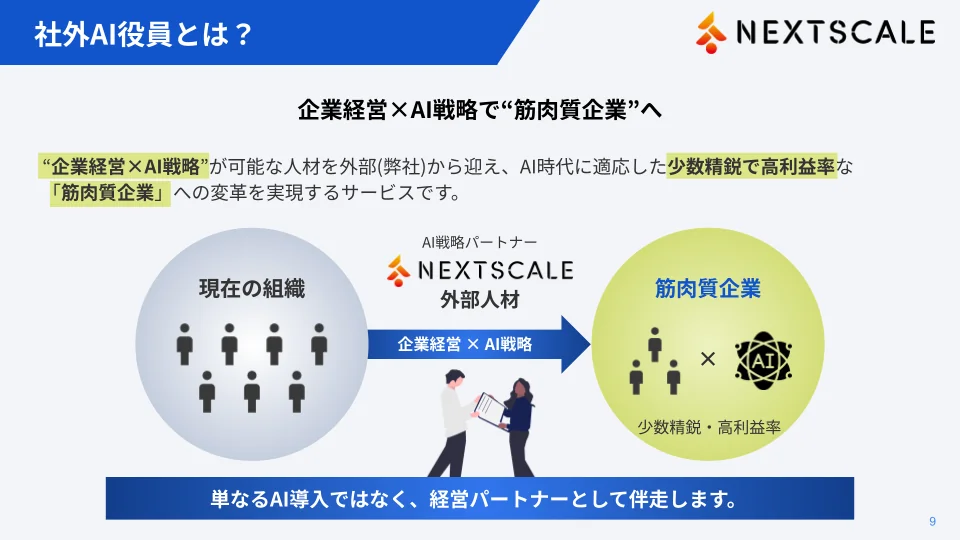
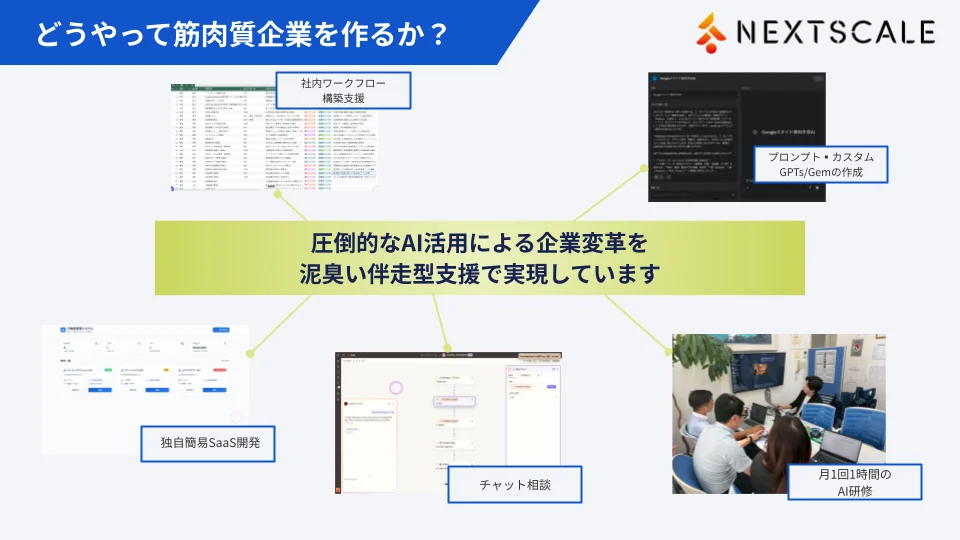
AIコンサル・AX伴走支援サービスご紹介資料
この資料でこんなことがわかります!
- 社外AI役員とは
- 支援内容
- 導入の進め方
- 導入実績・効果
\3ステップで簡単入力/
| システム設計の進め方から、無料で相談できます 受け取った設計書を承認してよいか判断したい、既存システムの構造に不安があるといった段階のご相談も承っています。 営業色は一切ありません。 ▶ 相談予約はこちら ※オンライン完結/秘密厳守/助成金活用のご相談も歓迎 |
この記事の監修者
株式会社ネクストスケール 代表取締役

関連記事
-
 AI受託開発とは?依頼できること・費用相場・開発会社の選び方と成功のポイントを解説
-
AI開発のPoCとは?進め方・費用・成功のポイントと「PoC止まり」を防ぐ方法を解説
-
バイブコーディングとは?やり方・おすすめツールとメリット・注意点を解説【2026年最新】
-
AIアプリおすすめ15選|無料で使える目的別の選び方と業務利用の注意点【2026年最新】
-
AIを活用したアプリ開発とは?手順・費用・おすすめツールまで解説
-
AIアプリ開発の費用相場は?内訳・種類別の目安と費用を抑える方法
-
AIアプリ開発をノーコードで実現!おすすめツールと進め方を解説
-
AIプロダクト開発の進め方とは?手順・開発手法・成功のポイントを解説