GPT APIの料金体系 モデル別の単価・トークンの計算方法・コスト削減の実践テクニック
 2026年9月14日
 著者:NEXT SCALE編集部
監修者:石丸真平
GPT APIを自社のサービスや業務システムに組み込みたいと考えたとき、最初に直面するのが「実際のところ、いったいいくらかかるのか」「月額でどれくらいの費用を見込んでおけばよいのか」という料金に対する率直な疑問です。GPT APIは月額固定制ではなく、使用したトークン(文字量の単位)に応じた従量課金制のため、費用の予測と管理には料金体系の仕組みとトークンの計算方法についての正しい理解が不可欠です。
さらに、2026年10月時点では、GPT-6シリーズ(GPT-6 Astra・GPT-6.1 Sol・GPT-6 Lunaなど)、GPT-5系、GPT-4.1系に加え、GPT-4oやGPT-4o miniも引き続き提供されており、モデルによって応答の品質、処理速度、そして料金が大きく異なっています。「高性能なモデルを使いたいがコストが心配」「どのモデルを選べば費用対効果が最も高いのか」という悩みは、APIの業務導入を検討している企業の担当者にとって、避けて通ることのできない共通の課題となっています。本記事では、GPT APIの料金体系の基本、モデル別の単価の目安、トークンの考え方、そして実務ですぐに実践できるコスト削減の具体的なテクニックまでを体系的に解説していきます(参照:OpenAI公式 料金ページ)。
| 確認したいポイント | 結論 |
| 料金体系はどうなっているか? | 使用したトークン数に応じた従量課金制。月額固定費なし。入力と出力で単価が異なる |
| 最も安いモデルはどれか? | GPT-5 nanoが最安。100万トークンあたり入力$0.05・出力$0.40(2026年10月時点) |
| コストを下げる方法はあるか? | Batch APIで50%割引、プロンプトキャッシュで最大90%削減、モデルの使い分けが有効 |
| 月額いくらくらいかかるか? | 用途と処理量による。社内チャットボット程度なら月額数千〜数万円で運用可能な場合もある |
この記事でわかること
・GPT APIの従量課金制の仕組みとトークンの基本的な考え方
・主要モデル別の料金単価の目安と用途に応じた選び方
・入力トークンと出力トークンの違いと費用への影響
・実務で使える5つのコスト削減テクニック
・月額費用の試算方法と予算管理のポイント
| \ AI導入・API活用のご相談はネクストスケールへ / ▶ 無料で経営相談する |
 こんな方におすすめ

GPT APIの料金体系の基本 ─ 従量課金とトークンの仕組み
GPT APIの料金は、「トークン」と呼ばれる単位で計算される従量課金制です。月額固定の料金は発生せず、実際に処理したトークンの量に応じて費用が請求されます。一切使わなければ費用は完全にゼロのままであり、実際にAPIを通じて処理を行った量、すなわち消費したトークンの数に正確に比例して課金されるという、利用者にとって非常に合理的で透明性の高い仕組みが採用されています。
トークンとは何か
トークンとは、AIが文章を処理する際の最小単位です。英語では1単語がおおむね1つから2つのトークンに変換され、日本語では漢字やひらがなを含む1文字がおおよそ1〜3個のトークンに変換されるのが一般的です。日本語は英語よりもトークン数が多くなりやすいため、同じ情報量であっても日本語で処理するほうがコストが高くなる傾向があるという特性を、正確な予算計画を立てるための第一歩として事前に理解しておくべきです。
入力トークンと出力トークンで単価が異なる
GPT APIでは、ユーザーが送信する文章(入力)と、AIが返す文章(出力)のそれぞれに対して異なる単価が個別に設定され、両方の合計がAPIの利用料金として請求されるという二層構造の課金体系が採用されています。業界の標準的な傾向として、AIが文章を生成する際に消費される出力トークンのほうが、ユーザーの入力を処理する入力トークンよりも高い単価が設定されているため、AIの回答を短くまとめるよう指示するだけでも、APIの利用にかかる毎月のコスト抑制に直接つながります。
100万トークンあたりの単価で表示される
GPT APIの料金は「100万トークンあたり何ドル」という単位で表示されるのが標準です。実際の利用では1回のやり取りで数百〜数千トークン程度を消費するのが一般的であるため、1回あたりのコストは日本円で1円にも満たないような小さな金額で収まることがほとんどです。ただし、処理回数が増えるほど総額への影響が大きくなるため、月間を通じた利用量を計画的に把握し、予算の範囲内に収める管理の重要性が格段に高まります。
モデル別の料金と用途の選び方
GPT APIでは複数のモデルが提供されており、モデルによって性能・速度・料金が異なります。ここでは代表的なモデルの特徴と料金帯を整理します。なお、料金は変更される可能性があるため、最新かつ正確な料金は必ずOpenAI社の公式ウェブサイト上の料金一覧ページを直接参照して確認するようにしてください。
軽量・低コストモデル ─ 定型業務の大量処理向け
GPT-5 nano(入力$0.05・出力$0.40)、GPT-6 Luna(入力$0.10・出力$0.50)、GPT-4.1 nano(入力$0.10・出力$0.40)などの軽量モデルは、100万トークンあたりの単価が最も安く、AIからの応答が返ってくるまでの速度も非常に速い特徴を持っているため、チャットボットの定型応答、文章の要約、データの分類といった一件あたりの処理コストを可能な限り低く抑えながら、大量のリクエストを高速にこなさなければならない業務用途に非常に適しています。最高性能のモデルと比較して応答の精度が多少下がる場合があっても、個々の応答の精度よりも、処理量の多さと一件あたりのコストの安さが優先される用途において最適な選択です。
標準モデル ─ 品質とコストのバランスが良い
GPT-6.1 Sol(入力$2.00・出力$10.00)やGPT-4.1(入力$2.00・出力$8.00)は、高い品質の応答を生成する能力を持ちながらもコストが比較的手頃に抑えられている、最もバランスの良い選択肢です。社内の業務支援ツール、顧客向けのチャットサポート、文書の作成補助など、一定以上の応答品質が業務上求められるものの、同時にコストの効率性も無視できない実務的な場面で品質と費用のバランスを重視する多くの企業に広く採用されています。
高性能モデル ─ 複雑な推論や高精度な処理向け
GPT-6 Astra(入力$10.00・出力$50.00)やGPT-5.5 Pro(入力$30.00・出力$180.00)などの高性能モデルは、複雑な推論、長文の分析、高度なコード生成といった、精密さと深い理解力が要求される高度な業務用途において最も真価を発揮します。単価は高めですが、AIが生成する出力の品質と正確性が、そのまま業務上の重要な成果やサービスの信頼性に直結するような場面においては、投じたコスト以上の業務的な価値を十分に発揮してくれます。
用途に応じてモデルを使い分けることが、API利用料金を適正な水準に抑えるための最も基本的な戦略であり、実行の容易さと削減効果の大きさの両面においても優れています。「すべての処理を最高性能のモデルで行う」のではなく、「この処理は軽量モデルで十分、この処理は高性能モデルが必要」と判断して振り分けることで、業務に必要な応答の品質水準を犠牲にすることなく、月間のAPI利用にかかる総コストを大幅に抑えることが可能になります。
 サービス資料をダウンロードする
GPT APIのコスト削減テクニック5選
1. 用途に応じてモデルを使い分ける
前述のとおり、社内で発生するすべてのAPIリクエストに対して一律に高性能・高コストなモデルを使用する必要はまったくなく、むしろコスト効率の観点から見ると著しく非効率な使い方であるといえます。定型的な分類や要約には軽量モデル、複雑な分析や文章生成には高性能モデルという使い分けを行うだけで、月間に発生するAPIの利用料金を半分以下にまで大幅に圧縮できるケースも実際に報告されています。
2. Batch APIを活用して50%の割引を受ける
即時に回答が必要ないリクエスト(たとえば夜間のバッチ処理や定期レポートの生成など)は、Batch APIを利用することで通常料金の50%割引で処理できます。ユーザーへの即時応答が求められないバックグラウンドで実行する処理をBatch APIに移行するのは、同じ処理結果を得ながら大幅なコスト削減を実現できる、手軽で効果の大きいコスト削減の代表的な手法です。
3. プロンプトを短く効率的に設計する
入力トークンの量が多いほど費用がかかるため、プロンプト(AIへの指示文)はAIに伝えるべき必要十分な情報だけを厳選して含め、無駄に長い説明や冗長な前置きを省くことでコストを削減できます。同じ結果を得るのに、プロンプトの書き方を工夫するだけで入力に消費されるトークン数を30〜50%も削減できることが、多くの開発現場で繰り返し確認されています。
4. プロンプトキャッシュを活用する
同じシステムプロンプト(前提条件の指示文)を繰り返し使う場合、プロンプトキャッシュ機能を利用することで、キャッシュされた入力部分の料金が最大50〜90%割引になります。チャットボットのように同一の前提条件のもとで大量のリクエストを連続的に処理する場面では、他のどの削減手法よりも大きなコスト削減効果を見込むことができるため、積極的に活用すべき非常に有用な機能です。
5. 出力の長さを制御する
出力トークンは入力トークンよりも単価が高いため、AIの回答を必要以上に長くさせないことがコスト管理の重要なポイントです。「回答は200文字以内で簡潔にまとめてください」「箇条書き3点で回答してください」といった指示をプロンプトに加えるだけで、出力として消費されるトークンの数を効果的かつ確実に抑えることが可能になります。
関連記事:業務効率化アイデア55選|部門別30+AI15+明日から3つで成果を出す方法
| \ AI導入・API活用のご相談はネクストスケールへ / ▶ 無料で経営相談する |
月額費用の試算方法と予算管理のポイント
GPT APIの月額費用は、「1回のリクエストで消費する平均トークン数」×「月間の想定リクエスト回数」×「モデルの単価」という計算式で、おおよその概算値を事前に導き出すことが可能です。
たとえば、GPT-5 nanoで1回あたり入力500トークン・出力500トークンの処理を月に1,000回行う場合、費用は約0.23ドルで、1ドル150円で換算すると月35円ほどです。一方、高性能モデルで長文の分析を月に数千回行う場合は、処理の内容と回数によっては月額で数万円、場合によっては数十万円の規模にまで達する可能性があることも事前に理解しておく必要があります。
予算管理のポイントとしては、OpenAIの管理画面で利用上限額を設定しておくことが最も確実な対策です。あらかじめ設定した上限金額に利用料が達した時点でAPIの呼び出しが自動的に停止される仕組みが用意されているため、「気づいたら想定以上に費用がかかっていた」という事態を未然に確実に防ぐことが可能です。
また、開発の初期段階では軽量モデルで動作確認と精度の検証を行い、本番のサービス環境で求められる品質水準を満たせることが確認できた段階で、適切なモデルに切り替えていくという段階的なアプローチも、無駄な費用の発生を最小限に食い止めるための効果的な方法です。
GPT APIの導入を検討する際の注意点
料金は随時改定される
OpenAIは新しいモデルの追加や既存モデルの料金改定を頻繁に行っています。本記事の情報はあくまで執筆時点の目安であり、常に最新の料金情報を確認したい場合は、必ずOpenAI社の公式ウェブサイトを直接参照するようにしてください。料金改定は値下げの方向で行われることが多いため、定期的にチェックすることで、よりコスト効率の高いモデルに切り替えるチャンスを逃すことのないように常に意識しておくようにしましょう。
セキュリティとデータの取り扱いを確認する
GPT APIに送信したデータがどのように扱われるかは、企業の情報管理方針に照らして事前に確認しておくべき重要な事項です。OpenAIは利用規約の中でデータの取り扱いに関する方針を明示しています。機密情報や個人情報をAPIに送信する場合は、自社の情報セキュリティ担当者と相談のうえ、データの取り扱い範囲と安全対策を明記した適切な運用ルールを策定しておきましょう。
社内利用と外部公開でコスト構造が異なる
社内の業務ツールとしてGPT APIを利用する場合と、顧客向けのサービスに組み込む場合では、想定されるリクエスト数と必要な応答品質が大きく異なるため、想定すべきコストの構造と規模感がまったく異なったものになります。外部公開のサービスではユーザー数の増加に比例してAPI費用が増えるため、利用者数の増加を想定した段階的な費用試算を事前に行い、収益モデルとの整合性を検証しておくことが不可欠です。
関連記事:AI研修とは|目的・種類・費用・助成金から失敗しない選び方まで
まとめ
GPT APIの料金は、使用したトークン数に応じた従量課金制で、月額固定費は発生しません。料金はモデルの種類と処理量によって決まり、軽量モデルであれば非常に低コストで利用できる一方、高性能モデルは単価が高くなるため、用途に応じた使い分けがコスト管理の基本になります。
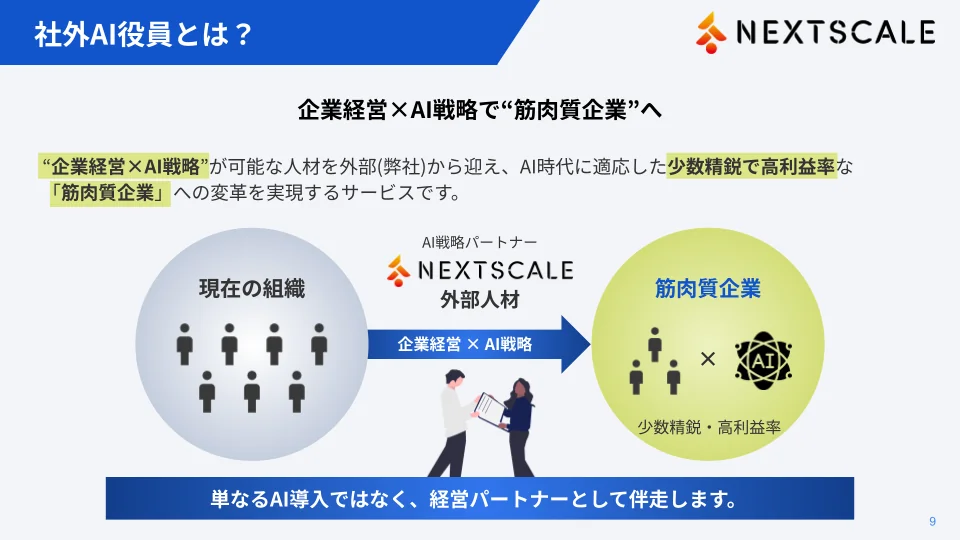
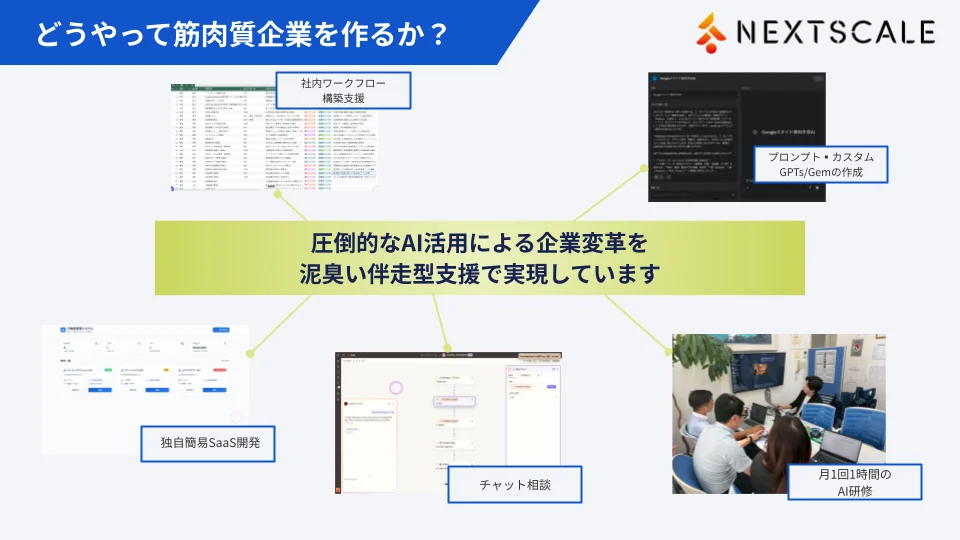
コスト削減の手段としては、モデルの使い分け、Batch APIによる50%割引、プロンプトの効率的な設計、プロンプトキャッシュの活用、出力の長さの制御という5つのテクニックが有効です。月額費用の試算は「平均トークン数×リクエスト回数×単価」で概算でき、OpenAIの管理画面で利用上限額を設定しておけば予算超過を防ぐことができます。料金は頻繁に改定されるため、最新情報は必ずOpenAI公式サイトで確認してください。「GPT APIの導入費用を試算したい」「自社の業務に合ったモデル選定を相談したい」という方は、ネクストスケールにお気軽にご相談ください。
AIコンサル・AX伴走支援サービスご紹介資料
この資料でこんなことがわかります!
- 社外AI役員とは
- 支援内容
- 導入の進め方
- 導入実績・効果
\3ステップで簡単入力/
この記事の監修者
株式会社ネクストスケール 代表取締役

関連記事
-
 AI受託開発とは?依頼できること・費用相場・開発会社の選び方と成功のポイントを解説
-
AI開発のPoCとは?進め方・費用・成功のポイントと「PoC止まり」を防ぐ方法を解説
-
バイブコーディングとは?やり方・おすすめツールとメリット・注意点を解説【2026年最新】
-
AIアプリおすすめ15選|無料で使える目的別の選び方と業務利用の注意点【2026年最新】
-
AIを活用したアプリ開発とは?手順・費用・おすすめツールまで解説
-
AIアプリ開発の費用相場は?内訳・種類別の目安と費用を抑える方法
-
AIアプリ開発をノーコードで実現!おすすめツールと進め方を解説
-
AIプロダクト開発の進め方とは?手順・開発手法・成功のポイントを解説