OpenAI Whisperとは 仕組みとモデル構成、APIの料金と他サービスとの違い
 2026年9月16日
 著者:NEXT SCALE編集部
監修者:石丸真平
「Whisperという音声認識モデルが高精度らしいが、何がどう違うのかわからない」「自社のシステムに組み込めるのか、判断する材料が足りない」。技術選定を任された立場では、こうした疑問が先に立ちます。
WhisperはOpenAIが公開している音声認識システムです。オープンソースとして提供されており、自社の環境でも、APIとしても利用できます。この選択肢の広さが、他のサービスとの大きな違いになっています。
この記事では、Whisperの仕組みと特徴を公式情報をもとに整理したうえで、モデルの構成、3つの利用形態と料金、できないこと、そして業務に組み込む際の設計までをまとめます。
| 確認したいポイント | 結論 | 詳細 |
|---|---|---|
| Whisperとは? | OpenAIが公開した音声認識システム | 68万時間の多言語データで学習し、モデルと推論コードが公開されています。 |
| どう使える? | 自社環境・API・クラウド経由の3通り | 扱う音声の機微度と処理量によって、適した形態が変わります。 |
| APIの料金は? | 音声1分あたり約0.006ドル | 1時間あたり約0.36ドルです。自社環境で動かせば費用はかかりません。 |
| できないことは? | 話者の識別とリアルタイム処理 | 誰が話したかは判別できません。長時間の音声も分割が必要です。 |
この記事でわかること
- Whisperの仕組みと、公式が示している学習データとアーキテクチャ
- 多言語対応や翻訳機能など、Whisperが持つ5つの特徴
- 6種類のモデル構成と、用途に応じた選び方
- 自社環境・API・クラウド経由という3つの利用形態と料金
- できないことと、業務システムへ組み込む際の設計のポイント
| 音声データの活用を検討している方へ AIを使った業務自動化の進め方と、社内で回し続ける体制づくりをまとめたサービス資料を無料で配布しています。 ▶ 資料請求はこちら |
 こんな方におすすめ

WhisperはOpenAIが公開している音声認識システム
Whisperは、音声をテキストに変換する自動音声認識のシステムです。ChatGPTで知られるOpenAIが開発し、モデルと推論コードをオープンソースとして公開しています。
公開されているという事実が、他の音声認識サービスとの決定的な違いを生んでいます。自社のサーバーやパソコンで動かせるため、音声を外部へ送らずに処理できます。
まずは公式が示している学習の規模と、内部の仕組みを確認します。
68万時間のデータで学習している
OpenAIの公式発表によると、Whisperはウェブから収集された68万時間に及ぶ多言語・マルチタスクの教師ありデータに基づいて学習した自動音声認識システムです。このような大規模で多様なデータセットを使用することで、アクセントや背景の雑音、専門用語に対するロバスト性が向上することが示されています。あわせて、多言語での文字起こしや、多言語から英語への翻訳も可能とされています(出典:OpenAI「Whisper が登場」 https://openai.com/ja-JP/index/whisper/ )。
訛りや雑音に強いという特性は、この学習データの多様さに由来します。きれいに録音されたスタジオ音声だけでなく、実環境に近い音声を大量に学習している点が効いています。
アーキテクチャは音声を30秒ずつ処理する仕組み
公式の説明によると、Whisperのアーキテクチャはエンコーダーとデコーダーを組み合わせたTransformerとして実装されています。
入力された音声は30秒のまとまりに分割され、音の特徴を表す形式に変換されたうえでエンコーダーに渡されます。デコーダーは、それに対応するテキストを予測するよう学習されています。
言語の識別、フレーズ単位の時刻情報、多言語の書き起こし、英語への翻訳といった複数の処理を、1つのモデルで切り替えて実行できる設計になっています。
オープンソースであることの意味
OpenAIは、有用なアプリケーションの構築や、音声処理のさらなる研究の基礎となるようモデルと推論コードを公開したと説明しています。
この結果、誰でも自由に使えるだけでなく、Whisperを土台にした派生の実装も多数生まれました。処理を高速化したもの、リアルタイムに対応したものなど、用途に応じた選択肢があります。
公開から時間が経ち、動作の検証情報や実装例が豊富に蓄積されている点も利点です。導入時につまずいても、解決の手がかりを見つけやすくなります。
技術選定の観点では、特定の企業に依存しない点が価値になります。サービスが終了しても、手元のモデルは動き続けます。
Whisperの5つの特徴
他の音声認識サービスと比較する際、どこが強みなのかを押さえておくと判断しやすくなります。ここでは5つに整理します。
いずれも公式に示されている機能をもとにしています。
特徴1|多言語に対応している
日本語を含む多数の言語に対応しています。言語を指定して処理することも、自動で判定させることもできます。
ただし、言語によって精度には差があります。公式のリポジトリでも、言語ごとの誤り率が公開されており、性能が言語によって大きく変わることが示されています。
日本語の音声を扱う場合は、英語専用ではなく多言語対応のモデルを選んでください。名称の末尾で区別できます。
特徴2|雑音や訛りに強い
実環境で録音された音声を大量に学習しているため、多少の背景音があっても文字起こしが成立します。会議室の空調音や、屋外の環境音がある音声でも実用に足る結果が出ます。
ただし限界はあります。複数人が同時に話す場面や、話者から遠い位置で録音された音声では、精度が大きく落ちます。
特徴3|翻訳もできる
多言語の音声を英語のテキストへ直接変換する機能があります。音声認識と翻訳を別々に行う方式に比べ、処理の手順が少なくて済みます。
ただし、翻訳先は英語に限られます。日本語への翻訳が必要な場合は、文字起こしの後に別途処理する構成になります。
特徴4|時刻情報を出力できる
どの発言が何分何秒に話されたかを、フレーズ単位で出力できます。動画の字幕作成や、後から音声を確認したい場面で役立ちます。
議事録では、修正作業の効率が変わります。誤変換を見つけたときに、該当箇所の音声へすぐ戻れるためです。
出力の形式は複数から選べます。文字だけのテキスト、時刻情報を含む形式、字幕用の形式など、後工程に応じて指定してください。
特徴5|商用利用が可能
公開されているライセンスの範囲で、商用のサービスにも組み込めます。自社製品に音声認識の機能を追加する用途にも使えます。
利用の前には、必ず公式のリポジトリでライセンスの条件を確認してください。派生の実装を使う場合は、そちらの条件も併せて確認が必要です。
自社サービスに組み込む場合は、法務の確認を挟んでください。利用そのものに制約がなくても、提供する形態によって求められる表示が変わることがあります。
 サービス資料をダウンロードする
モデルの構成と選び方
Whisperには複数のモデルが用意されており、大きさによって精度、速度、必要なメモリが変わります。
自社環境で動かす場合、この選択が実用性を大きく左右します。大きすぎると処理が終わらず、小さすぎると精度が足りません。
6種類のモデルが公開されている
公式のリポジトリでは、モデルのパラメータ数、必要なVRAM、相対的な速度が一覧で示されています。
- tiny:39M、約1GB、約10倍速
- base:74M、約1GB、約7倍速
- small:244M、約2GB、約4倍速
- medium:769M、約5GB、約2倍速
- large:1550M、約10GB、1倍速
- turbo:809M、約6GB、約8倍速
速度は、largeを基準としたときの相対値です。tinyは約10倍速く処理できる代わりに、精度は最も低くなります。
turboはlarge-v3を最適化したモデル
公式の説明によると、turboはlarge-v3を最適化したもので、精度の低下を最小限に抑えつつ高速な文字起こしを実現するとされています。
業務で使うなら、turboが有力な選択肢になります。largeに近い精度を保ちながら、処理時間が大幅に短くなるためです。
ただし、turboは翻訳の用途には対応していないとされています。音声を英語へ変換したい場合は、mediumまたはlargeを選んでください。
選ぶときの考え方
まずsmallで動作を確認し、精度が足りなければ段階的に上げていく進め方が確実です。最初から大きいモデルを使うと、処理が終わらない原因を切り分けられません。
比較する際は、自社で実際に扱う音声を使ってください。きれいに録音されたサンプルで試しても、本番での実力はわかりません。
処理時間も同時に測ってください。精度が高くても、1時間の音声に数時間かかる構成では業務に組み込めません。
| 自社での活用方法を相談したい方へ 扱う音声の内容と処理量を伺い、適した利用形態と進め方を整理します。30分のオンライン相談は無料で、しつこい営業はいたしません。 ▶ 相談予約はこちら |
3つの利用形態と料金
Whisperを使う方法は1つではありません。それぞれ費用とデータの扱いが異なるため、要件に応じて選んでください。
ここでは3つの形態を整理します。
形態1|自社の環境で動かす
モデルをダウンロードして、自社のサーバーやパソコンで実行する方法です。モデルの利用そのものに費用はかかりません。
音声を外部へ送らずに処理できる点が最大の利点です。機密性の高い会議や面談の記録を扱う場合、この形態が現実的な選択になります。
一方で、環境を用意する手間と、処理装置の性能に速度が左右される点は前提になります。処理量が多い場合は、相応の設備投資が必要です。
手元のパソコンで無料で動かす具体的な手順は、Whisperで無料文字起こしする方法|モデルの選び方と導入手順で解説しています。
形態2|OpenAIのAPIを使う
OpenAIが提供するAPIを呼び出す方法です。環境の準備が不要で、自社のシステムから簡単に組み込めます。
料金は処理した音声の時間に応じた従量課金です。whisper-1のモデルでは、音声1分あたり0.006ドル、1時間あたりおよそ0.36ドルとされています。10時間分を処理しても数ドル程度に収まる水準です。
1ファイルあたりのサイズに上限があるため、長時間の音声は分割して送る必要があります。実装の際は、この点を考慮した設計にしてください。
なお、OpenAIは音声認識について新しいモデルも提供しています。話者の識別に対応したものや、より安価なものもあるため、最新の選択肢と料金は公式の料金ページで確認してください。
APIと自社環境の分岐点は、処理する音声の総時間です。月に数時間ならAPIで十分ですが、数百時間を超えるなら自社環境を用意する価値が出てきます。
形態3|クラウド事業者経由で使う
大手のクラウド事業者が提供するサービスを通じて、Whisperを利用できる場合もあります。既存のクラウド環境と統合しやすい点が利点です。
事業者によっては、話者の識別や大容量ファイルのバッチ処理といった、Whisper単体にはない機能を組み合わせて提供しています。
すでに特定のクラウドを使っている企業であれば、この選択肢を先に検討する価値があります。認証やデータの保管を既存の仕組みに揃えられるためです。
Whisperにできないこと
導入の判断には、できることと同じくらい、できないことの把握が必要です。ここでは4つの制約を挙げます。
いずれも仕様上の制約であり、設定で解決できるものではありません。必要な場合は、別の仕組みを組み合わせる設計になります。
話者の識別ができない
誰が話したかを区別する機能は含まれていません。出力されるのは、発言の内容が続けて並んだテキストです。
複数人の会議で発言者を分けたい場合は、別の技術を組み合わせるか、その機能を持つサービスを選ぶ必要があります。
簡易な対応として、録音時に名前を呼んでから話す運用にする方法もあります。完全ではありませんが、後から判別しやすくなります。
オンライン会議であれば、参加者ごとに音声を分けて録音できる場合もあります。その場合は個別に処理すれば、発言者を区別できます。
ファイルサイズと処理時間に制限がある
APIを使う場合、1ファイルあたりのサイズに上限があります。長時間の音声はそのまま送れないため、分割の処理を実装する必要があります。
自社環境で動かす場合はサイズの上限はありませんが、長い音声を一度に処理すると時間がかかり、途中で失敗する可能性も上がります。30分程度に区切るほうが安定します。
実際には話されていない文章が生成されることがある
無音の区間や聞き取りにくい部分で、実在しない内容が出力される現象が起こります。文章として自然なため、読んだだけでは気づけません。
重要な記録として使う場合は、音声と照合する工程を残してください。特に数値や固有名詞は、確認が欠かせません。
この現象の仕組みと対策については、AIのハルシネーションとは|原因と発生する仕組み、事例と対策で詳しく解説しています。
そのままではリアルタイム処理に向かない
音声を30秒のまとまりで処理する設計のため、話しながら即座に文字を表示するといった用途には、そのままでは対応できません。
リアルタイムに近い処理を実現する派生の実装もありますが、遅延と精度のバランスを検証したうえで採用を判断してください。
即時性が要件なら、最初から対応をうたうサービスを検討するほうが確実です。無理に転用すると、精度も安定性も中途半端になります。
| 業務への組み込みを検討したい方へ どの業務にどれだけの効果が見込めるか、判断材料をまとめた資料をご用意しています。稟議の参考資料としてもご活用いただけます。 ▶ 資料請求はこちら |
業務での活用が進んでいる領域
音声をテキストにできるようになると、これまで記録として残せなかった情報が資産に変わります。導入が進んでいる領域を整理します。
共通しているのは、音声のまま残していた情報を検索可能にすることです。ここに価値があります。
会議と商談の記録
最も導入が多い用途です。録音をテキスト化し、要約と決定事項を抽出する流れを組めば、議事録の作成時間が大きく減ります。
商談の記録では、顧客管理システムへの入力までつなげる構成もあります。商談後の事務作業をほぼなくせます。
コールセンターの応対記録
すべての通話をテキスト化して蓄積すると、よくある問い合わせの傾向が見えてきます。FAQの整備やマニュアルの改善につなげられます。
応対品質の確認にも使えます。全通話を人が聞くのは不可能ですが、テキストであれば特定の表現を検索して抽出できます。
ただし顧客の個人情報が含まれるため、処理する環境と保管の方法は事前に決めておいてください。
動画コンテンツの字幕作成
時刻情報を含む形式で出力すれば、動画編集のソフトへそのまま読み込めます。字幕の作成にかかっていた工数が大きく減ります。
検索性の向上という副次的な効果もあります。動画の内容がテキストとして残れば、必要な場面を探せるようになります。
現場の作業記録
手が塞がる作業では、音声で記録して後からテキスト化する運用が有効です。作業を中断せずに記録を残せます。
専門用語が多い現場では誤変換が増えるため、よく出る用語の置換表を用意しておくと修正の手間が減ります。
他の音声認識サービスとの違いと選び方
音声認識の選択肢はWhisperだけではありません。何を重視するかで、適したサービスは変わります。
ここでは判断の軸を整理します。
商用の文字起こしサービスとの違い
専用のサービスは、話者の識別、音声と同期した再生、共同編集、要約といった機能を備えています。文字起こしの後の作業まで含めて設計されている点が強みです。
Whisperが提供するのは、音声をテキストに変換する部分だけです。前後の工程は自分で用意する必要があります。
使う人が複数いる場合は、専用サービスのほうが向きます。全員に技術的な操作を覚えてもらうのは現実的ではありません。
選ぶときの4つの基準
候補を比較するときは、次の観点で確認してください。
- 音声を外部へ送れるか。機密性の高い内容なら自社環境での処理が前提になる
- 話者の識別が必要か。必要なら別の仕組みが要る
- 処理する量はどれくらいか。多ければ自社環境のほうが安くなる
- 文字起こしの後に何をするか。要約や共有まで必要なら専用サービスが早い
1つ目が最も重要です。ここが制約になる場合、他の条件がどれだけ良くてもクラウド型は選べません。
社内規程の確認は早い段階で行ってください。検証を進めてから外部送信が不可と判明すると、それまでの検討が無駄になります。
組み合わせるという選択もある
すべてを1つの方法で処理する必要はありません。機密性の高い音声は自社環境で、急ぐものはAPIでというように、性質に応じて使い分ける構成も有効です。
この場合も、出力されるテキストの形式は揃えておいてください。後工程の処理を共通化できれば、運用の負担が減ります。
将来的に別の手段へ切り替える可能性も考慮してください。特定の実装に強く依存した設計にすると、移行のたびに作り直しが発生します。
業務システムに組み込む際の設計
Whisperを使うこと自体は難しくありません。成果を分けるのは、前後の工程をどう設計するかです。
ここでは3つの観点を挙げます。
前処理で精度が決まる
精度を最も左右するのは、モデルの性能ではなく入力される音声の質です。雑音の除去、音量の正規化、無音区間の除去といった前処理を入れるだけで、結果は大きく変わります。
録音の段階での工夫も欠かせません。話者の近くにマイクを置く、環境音を減らすという基本を押さえるほうが、大きいモデルを使うより効果的な場合があります。
固有名詞が多い業務では、指示文であらかじめ用語を伝える方法も使えます。社名や商品名を渡しておくと、誤変換が減る場合があります。
後処理を含めて設計する
出力されるのは話し言葉のままのテキストです。フィラーや言い直しが残るため、そのままでは読みにくい文章になります。
生成AIと組み合わせれば、書き言葉への変換、要約、決定事項の抽出まで自動化できます。文字起こしを起点として、どこまで自動で仕上げるかを設計してください。
録音から整形、共有までを仕組みにする場合は、AI業務自動化・GAS開発のサービス内容もあわせてご確認ください。
セキュリティとコストの管理
音声には個人情報や機密情報が含まれることがあります。どの音声をどの経路で処理してよいかを、事前に社内で決めておいてください。
APIを使う場合は、利用量の上限を設定しておくと想定外の請求を防げます。処理する音声の総時間から、月額の目安を先に試算しておくことも有効です。
あわせて、録音そのものについても参加者の同意を得る運用にしてください。技術的な準備とは別に、必要な手続きになります。
| 音声データ活用を伴走支援します 業務の棚卸しから手段の選定、実装、現場への定着までを一気通貫でご支援しています。まずは現状の課題整理からご相談ください。 ▶ 相談予約はこちら |
まとめ|用途に応じて利用形態を選び、前後の工程まで設計する
WhisperはOpenAIが公開している音声認識システムです。68万時間の多言語データで学習しており、アクセントや背景の雑音、専門用語への強さが公式に示されています。
モデルと推論コードがオープンソースとして公開されている点が、他のサービスとの決定的な違いです。自社環境で動かせるため、音声を外部へ送らずに処理できます。
利用形態は、自社環境での実行、OpenAIのAPI、クラウド事業者経由の3つです。機密性の高い音声を扱うなら自社環境、手軽さを重視するならAPIという使い分けになります。
一方で、話者の識別、リアルタイム処理、実在しない文章の生成といった制約もあります。必要な機能が欠けている場合は、別の仕組みを組み合わせる設計が必要になります。
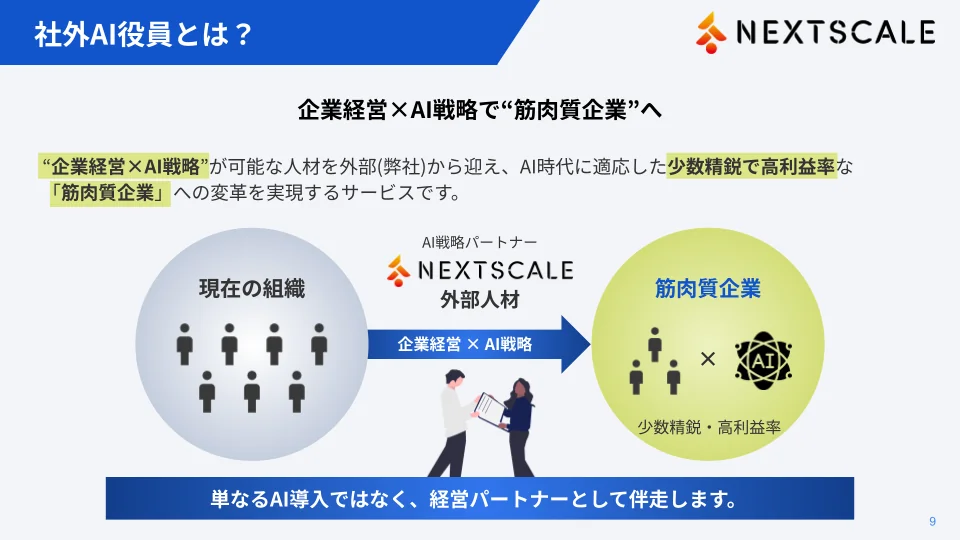
他社がどのような順番で業務を効率化したのかは、ネクストスケールの導入事例でご覧いただけます。
AIコンサル・AX伴走支援サービスご紹介資料
この資料でこんなことがわかります!
- 社外AI役員とは
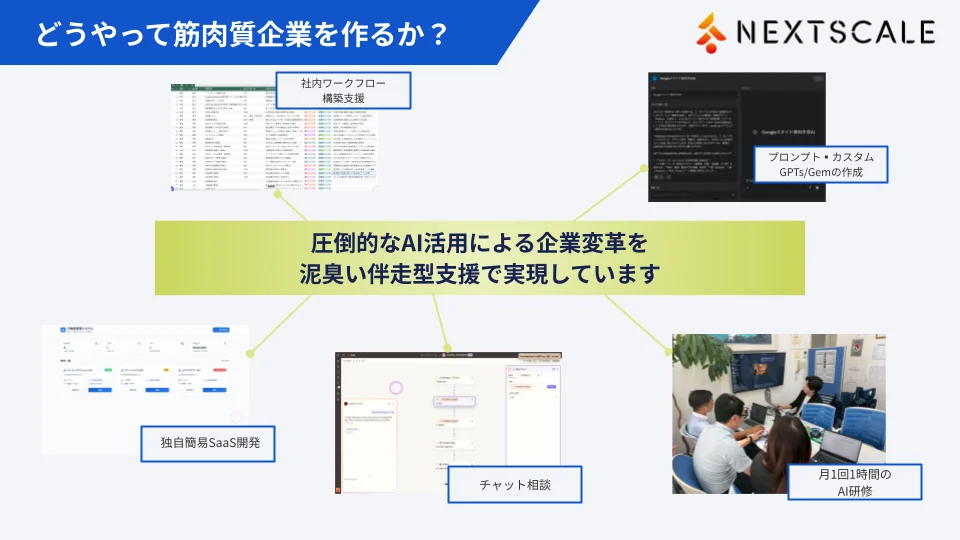
- 支援内容
- 導入の進め方
- 導入実績・効果
\3ステップで簡単入力/
| AI活用の進め方を無料でご提案します 貴社の業務を伺い、どこから着手すべきかを無料でご提案します。オンライン30分で完結し、助成金活用のご相談も歓迎しています。 ▶ 相談予約はこちら |
この記事の監修者
株式会社ネクストスケール 代表取締役

関連記事
-
 AI受託開発とは?依頼できること・費用相場・開発会社の選び方と成功のポイントを解説
-
AI開発のPoCとは?進め方・費用・成功のポイントと「PoC止まり」を防ぐ方法を解説
-
バイブコーディングとは?やり方・おすすめツールとメリット・注意点を解説【2026年最新】
-
AIアプリおすすめ15選|無料で使える目的別の選び方と業務利用の注意点【2026年最新】
-
AIを活用したアプリ開発とは?手順・費用・おすすめツールまで解説
-
AIアプリ開発の費用相場は?内訳・種類別の目安と費用を抑える方法
-
AIアプリ開発をノーコードで実現!おすすめツールと進め方を解説
-
AIプロダクト開発の進め方とは?手順・開発手法・成功のポイントを解説